Introducción
El primer fallo de un modelo no suele estar en el algoritmo. Está en la tabla. Una columna puede parecer impecable y, aun así, revelar el futuro, repetir clientes o mezclar poblaciones que ningún promedio representa. Si entrenas antes de entender eso, el procedimiento se ejecuta y la predicción no se puede defender.
El análisis exploratorio de datos, o EDA por Exploratory Data Analysis, es el trabajo de formular preguntas sobre un conjunto de datos, examinarlas con resúmenes y gráficos, y revisar las explicaciones que van apareciendo. No consiste en producir todos los gráficos posibles. Consiste en llegar a una lista de hallazgos, limitaciones y decisiones que puedas justificar. Los gráficos son instrumentos para construir esa lista, no el producto final.
Conviene separar desde el principio dos actividades que el lenguaje cotidiano mezcla. Explorar sirve para descubrir qué merece la pena comprobar. Confirmar sirve para comprobarlo con un diseño que no se haya adaptado a los mismos datos. Un patrón llamativo es una hipótesis. No es, todavía, un resultado.
En aprendizaje automático esa distinción tiene consecuencias concretas. El EDA te ayuda a definir cómo partir los datos, a detectar información que no existirá cuando tengas que predecir, a elegir variables y transformaciones, y a diseñar una evaluación acorde con el problema. También puede llevarte a una conclusión que conviene aceptar a tiempo: todavía no tienes datos suficientes para entrenar.
En esta guía trabajarás con un caso de abandono de clientes y, más adelante, con ejemplos separados de regresión y de series temporales. Cada figura va acompañada de su código, de una lectura de lo que muestra y de las precauciones necesarias para no leer de más. Necesitas conocer las estructuras básicas de Python. Los conceptos estadísticos se introducen en el momento en que hacen falta, con el ejemplo delante, no como un glosario previo.
Tabla de contenido
Tabla de contenido
- Qué debes obtener de un EDA
- Paso 1: define la pregunta y la unidad de observación
- Paso 2: prepara Python y genera los datos
- Paso 3: audita la estructura y reserva la prueba
- Paso 4: entiende la variable objetivo
- Paso 5: investiga los datos faltantes
- Paso 6: estudia distribuciones, escalas y transformaciones
- Paso 7: distingue atípicos, errores y casos importantes
- Paso 8: compara predictores con el objetivo
- Paso 9: examina correlaciones y busca lo que ocultan
- Paso 10: explora segmentos y proyecciones multivariables
- Paso 11: reconoce tendencias y cambios temporales
- Paso 12: adapta el análisis a una regresión
- Paso 13: convierte los hallazgos en un pipeline evaluable
- Casos de uso frecuentes y herramientas apropiadas
- Cómo redactar conclusiones útiles
- Ejercicios para practicar la interpretación
- Libros y artículos para seguir estudiando
- Videos para acompañar la práctica
- Resolución de problemas
- Fuentes verificadas
Qué debes obtener de un EDA
Organiza la exploración en cuatro niveles. No son fases que se cierran para siempre: son cuatro tipos de pregunta, y es normal volver atrás cuando una respuesta cambia el sentido de la anterior.
En el nivel estructural preguntas qué es cada fila y qué es cada columna. ¿Una fila es un cliente, una sesión, una factura o un día? ¿El identificador es único? ¿Las fechas comparten zona horaria? ¿Las unidades son comparables? Un error aquí contamina todo lo demás. Si promedias filas que no representan la misma cosa, el promedio no describe a nadie.
En el nivel univariante estudias una variable aislada: su distribución, sus valores faltantes, sus categorías y sus extremos. La pregunta útil no es solo «¿cuál es la media?». Es «¿la media resume esta variable, o la arrastra una cola que casi ningún individuo alcanza?».
En el nivel bivariante comparas dos variables. Puede ser un predictor frente al objetivo, o dos predictores entre sí. Aquí aparecen las primeras asociaciones. Todavía no sabes si se mantienen al tener en cuenta una tercera variable.
En el nivel multivariante buscas patrones que dependen de varias variables a la vez. Una asociación puede cambiar de signo según el plan contratado. Una proyección puede mostrar dos grupos que solo se separan al mirar tres columnas juntas. Este nivel es el más fácil de sobreinterpretar: siempre puedes encontrar algún corte de los datos que parezca revelador.
El proceso es iterativo. Una cola larga en un histograma puede llevarte a separar clientes particulares y empresas. Esa separación puede revelar un error de unidades, o puede explicar valores que, vistos todos juntos, parecían anómalos. Cada hallazgo reabre preguntas de los niveles anteriores.
La tabla siguiente es el mapa del capítulo. Cada fila une una pregunta, la evidencia que puede responderla y la decisión de modelado que esa evidencia está autorizada a cambiar. Si un gráfico no mueve ninguna de esas decisiones, es pronto para presentarlo como hallazgo.
| Pregunta | Evidencia que necesitas | Decisión que puede cambiar |
|---|---|---|
| ¿Qué representa una fila? | Clave de negocio, periodo y origen | Partir por filas, personas, grupos o tiempo |
| ¿Qué información existirá al predecir? | Momento de captura de cada variable | Excluir fugas y construir ventanas históricas |
| ¿A quién representan los datos? | Cobertura, muestreo, filtros y exclusiones | Limitar el alcance o recopilar otra muestra |
| ¿Qué problemas de calidad existen? | Ausencias, duplicados, rangos e inconsistencias | Corregir, imputar, marcar o investigar |
| ¿Qué relaciones aparecen? | Gráficos, tamaños de efecto y tamaños muestrales | Proponer variables y transformaciones |
| ¿Cómo se evaluará el modelo? | Coste de errores y condiciones de uso | Elegir métricas, particiones y referencias |
La primera fila, por ejemplo, no pregunta por un algoritmo. Pregunta qué es una fila. De la respuesta depende si partes al azar, por persona o por fecha. Las demás funcionan igual: sin evidencia no hay decisión, y sin una decisión posible el gráfico todavía no ha terminado su trabajo.
Explorar y confirmar son actividades distintas. Si pruebas cien comparaciones y solo enseñas la más llamativa, su nitidez puede ser un efecto de la búsqueda, no de la señal. Es el mismo fenómeno que hace que, entre muchas monedas lanzadas, alguna salga cara diez veces seguidas sin estar cargada. Registra las hipótesis que descubras y compruébalas con datos nuevos, o con una partición reservada antes de mirar. Un valor p pequeño, calculado después de explorar muchas alternativas, no convierte una hipótesis en un hecho. Una correlación, por clara que sea, tampoco es una relación causal.
Paso 1: define la pregunta y la unidad de observación
Antes de abrir la tabla, escribe la pregunta de forma que otra persona pueda señalar qué cuenta como acierto y qué cuenta como error. El caso principal cabe en una frase:
Con la información disponible hoy, ¿qué clientes activos abandonarán el servicio durante los próximos 30 días?
Esa frase fija tres piezas que el modelo no puede inventar después. El sujeto es el cliente activo, no la sesión ni la factura. El momento de la predicción es «hoy», una fecha de corte. El horizonte son los 30 días siguientes. Si más adelante alguien pide «predecir el abandono» sin precisar estas tres piezas, la tabla todavía no tiene un objetivo definido.
Cada fila representa un cliente en una única fecha de corte. Las sesiones y las incidencias corresponden a los 30 días anteriores; la etiqueta se observa durante los 30 siguientes. Esta separación temporal forma parte de la definición del problema, aunque la tabla final ya no traiga las fechas. Si la rompes —por ejemplo, contando una incidencia posterior al corte—, el modelo aprende algo que no podrá ver cuando tenga que decidir.
| Variable | Significado y tipo conceptual | Uso previsto |
|---|---|---|
cliente_id | Identificador, aunque esté almacenado como entero | Comprobar unicidad; excluir como predictor |
plan | Categoría nominal: Básico, Pro o Empresa | Predictor categórico |
antiguedad_meses | Tiempo desde el alta hasta el corte | Predictor numérico |
sesiones_30d | Conteo de sesiones anteriores al corte | Predictor numérico |
incidencias_30d | Conteo de incidencias anteriores al corte | Predictor numérico |
gasto_mensual | Gasto conocido al corte, en unidades monetarias ficticias | Predictor numérico con ausencias |
gasto_anual_estimado | Doce veces el gasto mensual, salvo redondeo | Ejemplo de redundancia |
abandono_30d | 1 si abandona después del corte; 0 si permanece | Variable objetivo |
reembolso_posterior | Reembolso conocido después del abandono | Fuga de información: excluir |
Lee la última columna como una decisión, no como una etiqueta decorativa.
reembolso_posterior es numérica, está completa y se correlacionará con el
abandono. Aun así se excluye, porque se conoce después del hecho que quieres
anticipar. Volveremos sobre ella: es el ejemplo de una fuga que ningún
preprocesamiento vuelve legítima.
El tipo con el que Python almacena una columna no es el tipo conceptual de la
variable. cliente_id puede llegar como entero y, aun así, no ser una
cantidad: promediar identificadores no significa nada, y la distancia entre el
cliente 10 y el cliente 11 no mide semejanza alguna. Lo mismo ocurre con
plan. Si sustituyes Básico, Pro y Empresa por 1, 2 y 3, un modelo lineal
interpretará que la distancia entre Básico y Pro es igual que la distancia
entre Pro y Empresa, y que Empresa «vale el triple» que Básico. Nada en el
enunciado justifica esa escala. El diccionario de datos —qué significa cada
columna, en qué unidades y en qué momento se conoce— manda sobre el dtype.
En una aplicación real escribe también la población elegible, la fuente de cada columna, la moneda, la zona horaria, los filtros de extracción y la fecha de actualización. Y comprueba que cada cliente tenga seguimiento suficiente. Una observación de ayer todavía no tiene una etiqueta completa a 30 días. Si la marcas como «no abandonó» solo porque el plazo no ha vencido, introduces etiquetas falsas: el modelo aprende que los clientes recientes nunca se van, que es lo contrario de lo que quieres detectar.
Paso 2: prepara Python y genera los datos
Usaremos pandas y NumPy para manipular tablas, Matplotlib para dibujar,
SciPy para estadísticas y scikit-learn para transformaciones y validación.
Pillow permite guardar las figuras como WebP. No necesitas GPU ni descargar
un conjunto de datos.
El programa hace dos cosas que en un proyecto real llegan separadas. Primero fabrica una población cuyo mecanismo conocemos. Después la explora como si ese mecanismo hubiera que descubrirlo. La ventaja didáctica es que, al final, puedes juzgar si una conclusión recupera lo que se puso dentro o si es una lectura de más. En datos reales no tendrás ese lujo: el mecanismo hay que reconstruirlo, y a veces no se puede.
python3 -m venv .venvsource .venv/bin/activatepython -m pip install numpy pandas matplotlib scipy scikit-learn pillowpython -m pip freeze > requirements-eda.txtpython analisis.pyAntes del último comando, guarda el programa completo como analisis.py:
descargar analisis.py.
Ponlo en tu directorio de trabajo. En PowerShell, activa el entorno con
.venv\Scripts\Activate.ps1. El programa crea graficos-eda/ con las 11
figuras, auditoria.csv y resultados.json.
Los ejemplos siguientes muestran fragmentos del mismo archivo. Ejecuta los
bloques Python en orden y en la misma sesión, o ejecuta el programa
completo. Los marcadores # %% permiten abrirlo como celdas en editores que
admiten ese formato. El backend Agg guarda imágenes sin abrir ventanas; en
un cuaderno puedes visualizar los archivos producidos.
from pathlib import Pathimport jsonimport platformfrom importlib.metadata import version
import numpy as npimport pandas as pdimport matplotlib
matplotlib.use("Agg")import matplotlib.pyplot as pltfrom scipy import statsfrom sklearn.compose import ColumnTransformerfrom sklearn.decomposition import PCAfrom sklearn.dummy import DummyClassifierfrom sklearn.impute import SimpleImputerfrom sklearn.linear_model import LinearRegression, LogisticRegressionfrom sklearn.metrics import (    average_precision_score,    mean_absolute_error,    precision_recall_curve,    roc_auc_score,)from sklearn.model_selection import (    StratifiedKFold,    cross_val_predict,    cross_validate,    train_test_split,)from sklearn.pipeline import Pipelinefrom sklearn.preprocessing import OneHotEncoder, StandardScaler
SALIDA = Path.cwd() / "graficos-eda"SALIDA.mkdir(exist_ok=True)plt.rcParams.update({    "figure.dpi": 150,    "font.size": 11,    "axes.spines.top": False,    "axes.spines.right": False,    "axes.grid": True,    "grid.alpha": 0.18,    "axes.axisbelow": True,    "savefig.facecolor": "white",})AZUL, NARANJA = "#0072B2", "#D55E00"resultados = {}

def guardar(fig, nombre):    fig.savefig(SALIDA / nombre, format="webp", bbox_inches="tight")    plt.close(fig)

print("Python:", platform.python_version())for paquete in ["numpy", "pandas", "matplotlib", "scipy", "scikit-learn", "pillow"]:    print(paquete, version(paquete))
Generamos 2400 clientes. Cada uno recibe un plan y un nivel de actividad. La probabilidad de abandono depende de la antigüedad, las sesiones, las incidencias y el plan. Esa probabilidad no se convierte en una etiqueta fija: se usa como la probabilidad de una moneda sesgada. Dos clientes parecidos pueden tener resultados distintos. Así el ejemplo no queda en una regla que clasifica todos los casos sin error, algo que casi nunca ocurre cuando el objeto de estudio son personas.
El generador introduce, a propósito, tres defectos que tendrás que descubrir. El gasto falta más a menudo en el plan Básico. Hay una antigüedad imposible, de −5 meses, escrita en la primera fila. Y las doce primeras filas se copian al final, de modo que el valor imposible viaja con la copia: por eso, antes de deduplicar, verás dos antigüedades negativas y no una. El reembolso posterior se calcula a partir de la propia etiqueta. Si el cliente abandona, aparece un importe; si no, el reembolso es cero. Esa columna revela el futuro por construcción.
rng = np.random.default_rng(42)n = 2400plan = rng.choice(["Básico", "Pro", "Empresa"], n, p=[0.62, 0.30, 0.08])antiguedad = rng.integers(1, 73, n)sesiones = rng.poisson(12, n)incidencias = rng.poisson(1.2, n)gasto = rng.lognormal(3.4, 0.7, n) * np.select( [plan == "Pro", plan == "Empresa"], [1.8, 3.2], default=1.0)logit = ( -0.8 - 0.025 * antiguedad - 0.08 * sesiones + 0.65 * incidencias + 0.55 * (plan == "Básico"))abandono = rng.binomial(1, 1 / (1 + np.exp(-logit)))df = pd.DataFrame({ "cliente_id": np.arange(n), "plan": plan, "antiguedad_meses": antiguedad, "sesiones_30d": sesiones, "incidencias_30d": incidencias, "gasto_mensual": gasto.round(2), "gasto_anual_estimado": (12 * gasto).round(2), "abandono_30d": abandono, "reembolso_posterior": abandono * rng.uniform(10, 100, n),})# La ausencia depende de una variable observada: el plan.falta_gasto = rng.random(n) < np.where(plan == "Básico", 0.22, 0.04)df.loc[falta_gasto, ["gasto_mensual", "gasto_anual_estimado"]] = np.nandf.loc[0, "antiguedad_meses"] = -5df = pd.concat([df, df.iloc[:12]], ignore_index=True)Conviene leer el bloque logit como la historia que el generador está
contando, no como un modelo que tú vayas a estimar. El término −0,8 fija un
nivel de partida. Los coeficientes de la antigüedad y de las sesiones son
negativos: a más meses de alta y a más uso reciente, menor es la tendencia a
abandonar. Los de las incidencias y del plan Básico son positivos: empujan en
el sentido contrario. Esas magnitudes no son efectos que el EDA deba recuperar
con exactitud, porque la etiqueta es aleatoria alrededor de esa tendencia.
La función logística, 1 / (1 + exp(−z)), solo comprime un número real
cualquiera a un valor entre 0 y 1, para poder usarlo como probabilidad. No
necesitas memorizar su fórmula para explorar los datos: aquí pertenece al
generador, no a tu análisis. En un proyecto real recibirías la tabla ya hecha
y tendrías que investigar si asociaciones parecidas existen. La ventaja de
este ejercicio es la contraria. Como el mecanismo está escrito unas líneas más
arriba, podrás juzgar después si una conclusión es fiel a los datos.
Paso 3: audita la estructura y reserva la prueba
Antes de mirar cómo se relaciona cada columna con el abandono, revisa el contrato de los datos: dimensiones, nombres, tipos, claves, duplicados y restricciones de dominio. Es el equivalente a comprobar que un instrumento mide lo que dice medir antes de interpretar la lectura.
Hay una distinción que conviene fijar aquí, porque el resto del capítulo depende de ella. Una regla de dominio, fijada de antemano y sin estimar nada a partir de los datos, puede aplicarse a la tabla completa. «La antigüedad no puede ser negativa» es una regla de ese tipo: no has aprendido un umbral, lo has traído del significado de la variable. Una regla estimada —una mediana, un percentil, una media y una desviación para escalar— debe aprenderse solo con el entrenamiento de cada partición. Si la calculas con toda la tabla, la prueba participa en una decisión que se supone que no ha visto.
Si cargas un CSV real, trata los identificadores como texto cuando puedan
tener ceros a la izquierda: un entero se los come, y dos clientes distintos
pueden colapsar en uno. Declara qué cadenas representan ausencia ("?",
"NA", "desconocido") antes de que pandas las lea como categorías
legítimas. Y revisa las conversiones de fechas y de cantidades. Una coma
decimal leída como separador de miles puede convertir un precio en texto, o
en un número mil veces mayor, sin que ninguna gráfica posterior te avise del
motivo.
En el ejemplo llegan 2412 filas y 9 columnas, con 12 duplicados exactos. Aparecen dos filas con antigüedad negativa porque la fila inválida también se copió. Después de quitar las copias quedan 2400 clientes y una sola antigüedad inválida. Esa antigüedad se transforma en ausente. No es una imputación: es el reconocimiento de que el valor registrado no puede haber ocurrido.
print("Dimensiones recibidas:", df.shape)print("Duplicados exactos:", int(df.duplicated().sum()))print("Antigüedades inválidas:", int((df.antiguedad_meses < 0).sum()))df = df.drop_duplicates().copy()# Regla de dominio prefijada; no estima parámetros del conjunto completo.df.loc[df.antiguedad_meses < 0, "antiguedad_meses"] = np.nanassert df.cliente_id.is_uniqueassert df.abandono_30d.isin([0, 1]).all()train, test = train_test_split( df, test_size=0.2, stratify=df.abandono_30d, random_state=42)train, test = train.copy(), test.copy()assert set(train.cliente_id).isdisjoint(test.cliente_id)print("Filas de entrenamiento y prueba:", len(train), len(test))auditoria = pd.DataFrame({ "tipo": train.dtypes.astype(str), "ausentes_pct": train.isna().mean().mul(100), "valores_distintos": train.nunique(dropna=False),})print(auditoria.round(2).to_string())auditoria.to_csv(SALIDA / "auditoria.csv")resultados["filas"] = {"entrenamiento": len(train), "prueba": len(test)}La eliminación de duplicados está justificada aquí porque cada fila debe representar un cliente único, y sabemos que las doce copias son un error de exportación. Hacerlo antes de partir evita que el mismo cliente, repetido, caiga a la vez en el entrenamiento y en la prueba. No borres filas iguales de forma automática en otros problemas. Dos compras por el mismo importe pueden ser transacciones distintas; borrar una de ellas borra un hecho. Si una misma clave tiene filas contradictorias —dos planes distintos para el mismo cliente y la misma fecha—, conservar «la primera» no resuelve el conflicto. Solo esconde que no sabes cuál es la versión correcta.
Reservamos un 20 % como prueba: quedan 1920 filas de entrenamiento y 480 de
prueba. La estratificación mantiene, en ambos lados, aproximadamente la
misma proporción de abandonos. Sin ella, un sorteo desafortunado podría dejar
la prueba casi sin positivos, y cualquier métrica calculada ahí sería
inestable. Usar la etiqueta para equilibrar la partición es legítimo. Usarla
para elegir variables mirando la prueba, no lo es. Desde este momento, las
figuras del caso de clientes usan exclusivamente train.
La partición aleatoria es apropiada para esta simulación: los clientes son independientes y comparten la misma fecha de corte. No basta para todos los problemas. La regla general es que la partición debe imitar la distancia que habrá entre el entrenamiento y el uso real. Si esa distancia es temporal, geográfica o de identidad, un sorteo de filas la rompe.
| Situación | Partición que debes considerar | Motivo |
|---|---|---|
| Filas independientes de una misma población | train_test_split y StratifiedKFold en clasificación | Representar ambas clases sin mezclar observaciones dependientes |
| Varias filas por persona, paciente o dispositivo | GroupShuffleSplit, GroupKFold o StratifiedGroupKFold | Evitar que la identidad del mismo individuo aparezca a ambos lados |
| Predicción de fechas futuras | Corte cronológico y TimeSeriesSplit cuando corresponda | Entrenar solo con el pasado |
| Ventanas temporales solapadas o etiquetas que tardan en completarse | Separación temporal con una distancia o purga adecuada | Evitar que información del horizonte de evaluación llegue al entrenamiento |
| Generalización a otra región o centro | Bloques geográficos o separación por centro | Reproducir la distancia entre entrenamiento y uso real |
Consulta los ejemplos de validación cruzada de scikit-learn
para implementar el diseño que corresponda. En datos irregulares, gap cuenta
filas, no días; comprueba que la separación realmente cubra el horizonte de
las etiquetas. Una purga de cinco filas no sirve de nada si esas cinco filas
cubren cinco minutos y la etiqueta tarda treinta días en completarse.
Paso 4: entiende la variable objetivo
En clasificación, el primer gráfico no es el más vistoso: es el recuento de clases. Antes de preguntarte qué separa a quienes abandonan, necesitas saber cuántos son y qué significa, operativamente, cada etiqueta. En regresión el equivalente es mirar la distribución y las unidades del objetivo. En ambos casos verifica quién etiqueta, con qué retraso, y si hay grupos cuyos resultados no se registraron. Una etiqueta que falta no es un cero.
conteo = train.abandono_30d.value_counts().sort_index()fig, ax = plt.subplots(figsize=(8, 4))barras = ax.bar(["Permanece (0)", "Abandona (1)"], conteo, color=[AZUL, NARANJA])ax.bar_label(barras, labels=[f"{v} ({v / len(train):.1%})" for v in conteo], padding=5)ax.set(ylabel="Clientes", title="Objetivo en entrenamiento", ylim=(0, conteo.max() * 1.18))guardar(fig, "01-objetivo.webp")resultados["abandono_pct"] = float(train.abandono_30d.mean() * 100)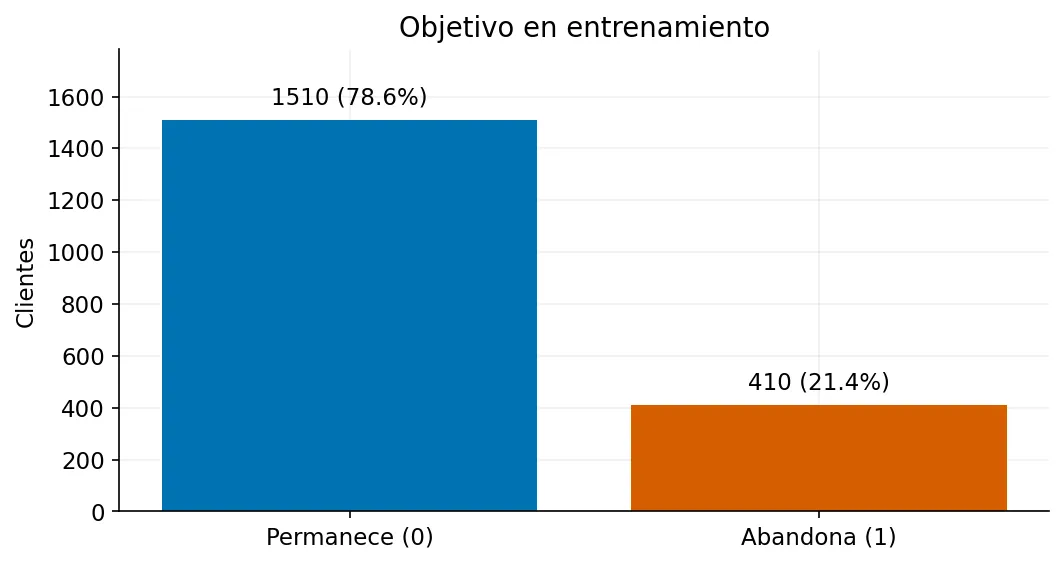
Hay 410 abandonos entre 1920 clientes, aproximadamente un 21,35 %. Conviene traducir ese porcentaje a una regla trivial, porque esa regla es el suelo contra el que vas a comparar cualquier modelo. Un clasificador que siempre responda «permanece» acertará el 78,65 % de las filas y no detectará ni un solo abandono. Si alguien te presenta un modelo con un 80 % de exactitud y no enseña nada más, puede estar a dos puntos de esa regla. La exactitud, cuando las clases están desbalanceadas, premia sobre todo acertar la clase mayoritaria.
Para elegir métricas, traduce los errores a decisiones. Un falso positivo es intervenir —una llamada, un descuento— sobre un cliente que no iba a abandonar. Un falso negativo es no detectar a alguien que sí se irá. El coste de cada error, y cuántas intervenciones puedes permitirte, determinan el umbral útil. No hay un umbral correcto independiente de esa capacidad.
Dos tasas describen ese compromiso, y no son intercambiables. La precisión responde: de los clientes que el modelo señaló, ¿qué fracción abandona de verdad? La exhaustividad, o recall, responde: de todos los que abandonan, ¿qué fracción consigues señalar? Subir una suele bajar la otra. Un modelo muy preciso que solo señala a diez clientes puede dejarte fuera a casi todos los abandonos. Un modelo muy exhaustivo que señala a mil puede llenar la cola de intervención de gente que no se iba a ir.
Si además vas a tratar las probabilidades como riesgos individuales —«este cliente tiene un 70 % de probabilidad de abandonar»—, ordenar bien no basta. Necesitas calibración: que, entre los clientes a los que asignas un 70 %, abandonen aproximadamente siete de cada diez. Un modelo puede ordenar de forma excelente y, aun así, exagerar o rebajar las probabilidades.
No equilibres las clases antes de separar los datos. Si duplicas abandonos en la tabla completa y luego partes, la prueba deja de parecerse a la población que verás en producción. Si experimentas con sobremuestreo, hazlo dentro de cada partición de entrenamiento; la evaluación debe conservar la prevalencia esperada. El desbalance, por sí solo, tampoco obliga a fabricar ejemplos sintéticos. Empieza por una referencia simple, mide, y decide si el problema es la métrica o los datos.
Paso 5: investiga los datos faltantes
Un valor ausente no es un número que se te olvidó escribir. Puede significar «no se midió», «no aplica», «falló la captura» o «la persona decidió no responder». Esas cuatro lecturas piden tratamientos distintos. Sustituirlas todas por cero las confunde, y además puede chocar con un cero que sí es un dato: un cliente con cero sesiones aporta información; un cliente cuyo número de sesiones no se registró, no.
Calcula primero la proporción de ausencias por columna y después por los
grupos que importan para la pregunta. Una media global puede esconder que la
falta se concentra en un segmento, y es el segmento —no el porcentaje— lo que
cambia la decisión. isna() detecta los marcadores de ausencia de pandas, no
las convenciones de tu fuente. Si el CSV usa "?" o "desconocido", pandas
los tratará como texto ordinario hasta que declares que significan falta de
información. La documentación de datos ausentes de pandas
explica los marcadores que la librería sí reconoce y cómo se propagan en las
operaciones.
columnas = ["gasto_mensual", "gasto_anual_estimado", "antiguedad_meses"]ausencias = train[columnas].isna().mean().mul(100).sort_values()por_plan = train.assign(falta_gasto=train.gasto_mensual.isna()).groupby("plan").falta_gasto.mean().mul(100)fig, axs = plt.subplots(1, 2, figsize=(11, 4), layout="constrained")axs[0].barh(ausencias.index, ausencias, color=AZUL)axs[0].set(xlabel="Valores ausentes (%)", title="¿Qué columnas faltan?")axs[1].bar(por_plan.index, por_plan, color=AZUL)axs[1].set(ylabel="Gasto ausente (%)", title="¿En qué grupos faltan?")guardar(fig, "02-ausencias.webp")resultados["gasto_ausente_por_plan_pct"] = por_plan.round(2).to_dict()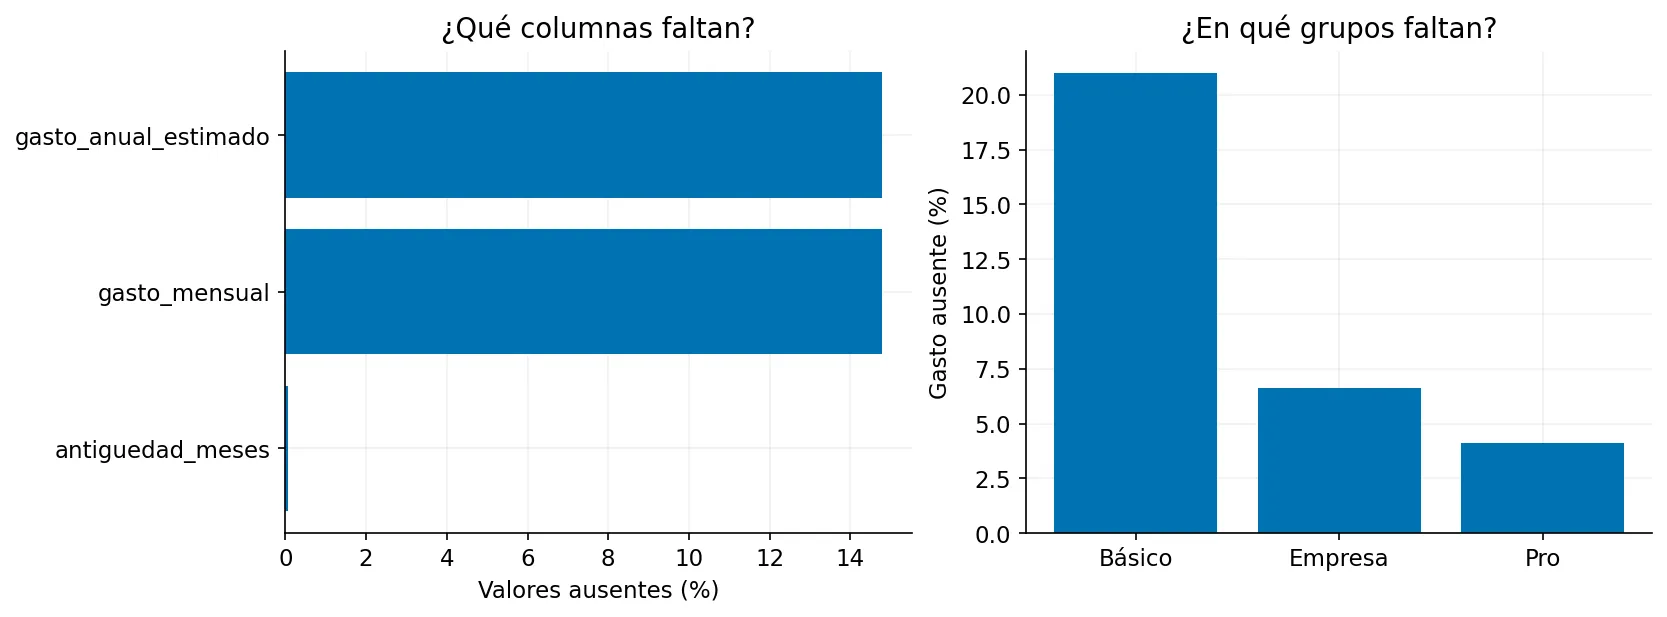
El gasto falta en el 14,79 % del entrenamiento. Desagregado por plan, la ausencia es del 20,97 % en Básico, del 6,63 % en Empresa y del 4,09 % en Pro. En el generador la probabilidad era 0,22 para Básico y 0,04 para los otros dos planes. Las tasas observadas no tienen por qué reproducir esas probabilidades: son una realización del sorteo, y con pocas filas el porcentaje se aleja del valor programado. Empresa es el plan menos frecuente —el generador le asigna probabilidad 0,08—, así que su 6,63 % no demuestra, por sí solo, un mecanismo distinto del 4,09 % de Pro.
El segundo panel cambia la decisión que el porcentaje global sugería. Si borras todas las filas sin gasto, no solo reduces la muestra: la empobreces sobre todo en Básico, que es además el plan con más abandono. Cualquier comparación posterior entre planes quedaría hecha sobre un subconjunto que ya no representa a los clientes originales.
Para hablar con precisión de este problema se usan tres mecanismos. No son diagnósticos que un gráfico pueda confirmar. Son hipótesis sobre el proceso de captura.
- MCAR, missing completely at random: la ausencia no depende de ningún valor, observado o no. Una pérdida al azar durante una transferencia, que afecta por igual a cualquier fila, se acerca a este caso. Es el supuesto más fácil de manejar y el menos frecuente.
- MAR, missing at random: una vez tienes en cuenta ciertas variables observadas, la ausencia ya no depende del valor que falta. En la simulación ocurre exactamente esto: la probabilidad de no observar el gasto se fija a partir del plan, no del importe. El nombre es equívoco. La ausencia no es aleatoria en el sentido cotidiano; lo es solo condicionada a lo que ya ves.
- MNAR, missing not at random: incluso después de condicionar por toda la información disponible, la ausencia sigue dependiendo del valor que no se observó. Ocurre, por ejemplo, si los importes muy altos se omiten y ninguna columna registra el motivo.
Conocemos el mecanismo del ejemplo porque lo escribimos en el generador. En datos reales, un gráfico de ausencias no demuestra MAR ni descarta MNAR. Ver que Básico tiene más huecos es compatible con las tres historias: puede que el formulario de ese plan falle más, puede que quienes gastan mucho en Básico dejen el campo vacío, o pueden ocurrir ambas cosas. Para distinguirlas necesitas conocer la captura, comparar con otra fuente y, si la duda persiste, repetir el análisis bajo varios supuestos y ver si la conclusión se mantiene. Eso es un análisis de sensibilidad.
Como primera aproximación predictiva puedes imputar la mediana y añadir un indicador de ausencia. La mediana debe aprenderse solo con el entrenamiento de cada pliegue. El indicador —una columna que vale 1 cuando el gasto faltaba— puede ayudar si el proceso de captura es estable, porque «no haber medido» a veces es informativo por sí mismo. También puede hacer que el modelo aprenda un fallo operativo que en producción ya no exista. La imputación simple, además, no reconstruye la variabilidad real: apila observaciones en un único valor y no garantiza que un intervalo calculado después sea válido.
Paso 6: estudia distribuciones, escalas y transformaciones
Un resumen numérico comprime una columna en unos pocos números. Esa compresión solo es útil si sabes qué arrastra cada número y qué deja fuera.
La media es el promedio: suma los valores y divide entre cuántos hay.
Cada observación entra con su magnitud, así que un extremo pesa lo mismo que
su tamaño. La mediana es el valor que deja aproximadamente la mitad de
las observaciones a cada lado; un importe enorme mueve la media y apenas
mueve la mediana. La desviación estándar resume cuánto se alejan los
valores de la media, en las mismas unidades de la variable. Los cuartiles
marcan el 25 %, el 50 % y el 75 % de la distribución acumulada. El rango
intercuartílico, IQR = Q3 − Q1, es la amplitud de la mitad central: una
medida de dispersión que ignora las dos colas.
Cuando la distribución tiene una cola larga, unos pocos valores altos arrastran la media por encima de la mediana. Si solo publicas la media, describes un cliente que casi no existe. Por eso el resumen y el gráfico se leen juntos: el número dice cuánto, y el gráfico dice si ese «cuánto» es representativo.
g = train.gasto_mensual.dropna()fig, axs = plt.subplots(1, 3, figsize=(13, 4), layout="constrained")axs[0].hist(g, bins="fd", color=AZUL, edgecolor="white")axs[0].axvline(g.mean(), color=NARANJA, label="Media")axs[0].axvline(g.median(), color="black", linestyle="--", label="Mediana")axs[0].set(xlabel="Gasto (unidades monetarias)", ylabel="Clientes", title="Escala original")axs[0].legend()axs[1].hist(np.log1p(g), bins=25, color=AZUL, edgecolor="white")axs[1].set(xlabel="log(1 + gasto)", ylabel="Clientes", title="Transformación logarítmica")axs[2].ecdf(g, color=AZUL)axs[2].axhline(0.9, color=NARANJA, linestyle="--")axs[2].set(xlabel="Gasto (unidades monetarias)", ylabel="Proporción acumulada", title="Distribución acumulada")guardar(fig, "03-distribuciones.webp")resumen = g.describe(percentiles=[0.25, 0.5, 0.75, 0.9, 0.99])print(resumen.round(2).to_string())resultados["gasto"] = resumen.round(2).to_dict()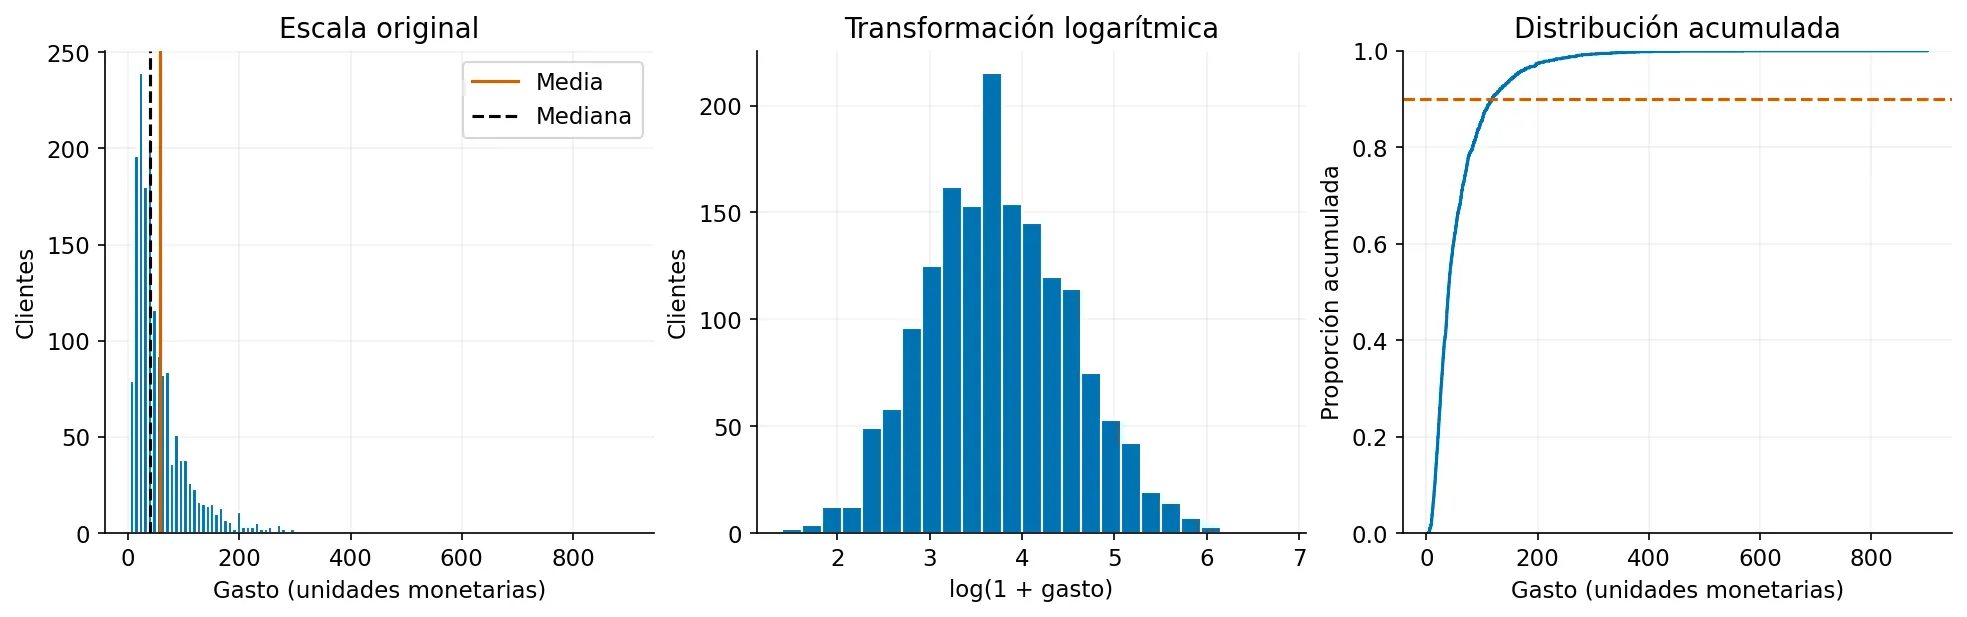
En los 1636 gastos observados, la media es 57,56, la mediana 39,50, el percentil 90 118,20 y el máximo 900,83. La diferencia entre media y mediana, (57,56 − 39,50) / 39,50, es cerca de un 46 %: la media no describe al cliente típico, describe el arrastre de la cola. La mitad de los gastos observados no pasa de 39,50, pero unos pocos importes muy altos suben el promedio hasta 57,56. El máximo es más de veinte veces la mediana. Ningún resumen de un solo número cuenta esa historia.
Lee cada panel como un instrumento distinto, no como tres formas de decir lo mismo.
- Histograma original. La altura de cada barra es el número de clientes
cuyo gasto cae en ese intervalo. La masa está en los importes pequeños y
hay una cola hacia la derecha. La media queda a la derecha de la mediana,
como cabía esperar. El número y el ancho de los intervalos cambian la
apariencia: con barras muy finas aparecen dientes que son ruido; con
barras muy anchas desaparecen huecos que sí estaban.
bins="fd"aplica la regla de Freedman–Diaconis, que fija el ancho a partir del IQR y del tamaño de la muestra. Es un punto de partida, no una verdad sobre la forma de la distribución. - Histograma transformado.
log1p(x)calcula el logaritmo natural de1 + x. Sumar uno permite incluir el cero, porque el logaritmo de cero no está definido. El logaritmo comprime los importes grandes: la distancia entre 10 y 100 se parece a la distancia entre 100 y 1000, no a la distancia lineal entre 10 y 100. Es otra representación de los mismos datos, no una corrección de errores. Aquí produce una forma menos asimétrica, más cómoda para ver la masa central y para ciertos modelos lineales. - Distribución acumulada empírica, o ECDF. Para cada importe x, la altura de la curva es la fracción de gastos observados menores o iguales que x. No elige intervalos, así que no depende de un ancho de barra. La altura 0,90 cae aproximadamente en 118,20: el 90 % de los gastos observados no supera esa cifra. Es la forma más directa de leer un percentil.
Estas estadísticas describen los gastos observados, no a todos los clientes. Las ausencias dependen del plan, así que los 1636 importes no son una muestra al azar de los 1920. La distribución que obtendrías después de imputar tendría, además, un pico artificial en el valor de sustitución: muchas filas apiladas en la mediana, que no corresponden a nadie que haya gastado exactamente eso. Conserva, en el gráfico y en el texto, la distinción entre lo medido y lo imputado.
Un logaritmo puede facilitar ciertos modelos lineales y ciertas visualizaciones. No es un requisito convertir todas las variables en normales. La regresión lineal no exige que cada predictor tenga distribución normal; si vas a interpretar inferencias, lo que importa es el comportamiento de los residuos, no la silueta de cada columna. Los árboles de decisión comparan umbrales dentro de una misma variable y no necesitan estandarización. En cambio, los métodos basados en distancias —y muchos modelos regularizados— sí son sensibles a la escala: una variable que va de 0 a 10 000 dominará a una que va de 0 a 1, aunque esta última sea más informativa.
Si usas una densidad suavizada, o KDE, revisa el ancho de banda y el soporte de la variable. El suavizado puede dibujar densidad sobre valores imposibles —gastos negativos, por ejemplo— o insinuar varios picos donde solo hay ruido. Con conteos pequeños, unas barras alineadas con los enteros suelen ser más claras. El tutorial de distribuciones de Seaborn compara estos recursos sobre los mismos datos.
Paso 7: distingue atípicos, errores y casos importantes
Un valor atípico es una observación inusual respecto de alguna referencia. La palabra no significa «error». Puede ser una captura incorrecta, un evento raro y real, o un caso perfectamente normal de otro grupo que mezclaste con el primero. La misma cifra cambia de categoría según el contexto: un gasto alto puede ser extraordinario entre particulares y habitual entre empresas.
El diagrama de caja resume una distribución sin mostrar cada valor. La línea
interior es la mediana. La caja va de Q1 a Q3 y contiene, por
construcción, la mitad central de los datos. Los bigotes, en la configuración
habitual de Matplotlib, llegan hasta la observación más extrema que todavía
cae dentro de 1,5 IQR a cada lado de la caja. Lo que queda fuera se dibuja
como punto, para que lo revises. La regla es:
Símbolos: es una observación; y son los cuartiles primero y tercero; . El factor 1,5 no sale de un teorema que separe datos correctos de incorrectos. Es una convención de exploración, útil para señalar candidatos a revisión. En una distribución simétrica y de colas cortas marca pocos casos. En una distribución con cola larga, como el gasto, marca muchos valores que pueden ser perfectamente reales.
q1, q3 = g.quantile([0.25, 0.75])iqr = q3 - q1limite = q3 + 1.5 * iqrmarcados = train.gasto_mensual > limitefig, axs = plt.subplots(1, 2, figsize=(11, 4), layout="constrained")axs[0].boxplot(g, orientation="horizontal")axs[0].axvline(limite, color=NARANJA, linestyle="--", label="Q3 + 1.5 IQR")axs[0].set(xlabel="Gasto", yticks=[], title="Regla global de revisión")axs[0].legend()planes = ["Básico", "Pro", "Empresa"]axs[1].boxplot( [train.loc[train.plan == p, "gasto_mensual"].dropna() for p in planes], tick_labels=planes,)axs[1].set(ylabel="Gasto", title="El contexto cambia la interpretación")guardar(fig, "04-atipicos.webp")resultados["atipicos"] = {"limite": round(float(limite), 2), "n": int(marcados.sum())}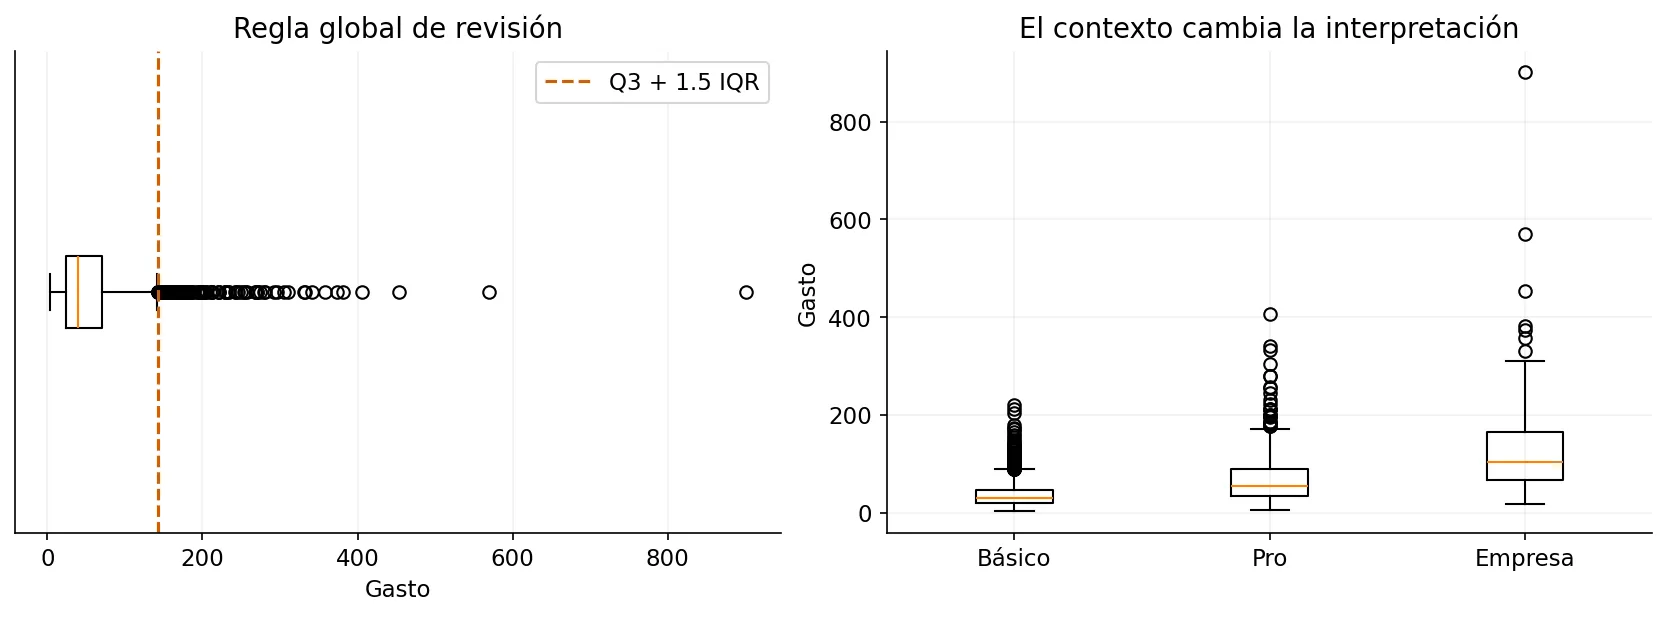
El límite superior global es 141,99 y señala 116 clientes. El panel por plan muestra por qué no conviene tratarlos como una clase única: Empresa vive en otra escala de gasto. La regla global mezcla poblaciones y marca parte de esa diferencia como si fuera excepcional. No eliminamos esos valores. El generador no introdujo errores de gasto; los extremos son la cola de una distribución asimétrica, no fallos de captura.
Ante un extremo en datos reales, la pregunta útil no es «¿supera el bigote?». Es «¿puede haber ocurrido?». Consulta unidades, comprobantes, límites físicos, historial y grupos comparables. Si confirmas un error, corrígelo o márcalo como ausente. Si el valor es válido, no lo borres para que el gráfico quede más limpio: considera una transformación, una función de pérdida robusta o métricas separadas por segmento. En fraude o en fallos de equipo, esos casos raros pueden ser precisamente lo que buscas. Eliminarlos sería eliminar la señal.
La puntuación z mide a cuántas desviaciones estándar está un valor de la
media. Con colas largas es poco informativa, y por una razón circular: la
propia media y la propia desviación están arrastradas por los extremos que
intentas detectar, así que el criterio se vuelve laxo justo donde querrías
que fuera estricto. El IQR y la desviación absoluta respecto de la mediana
ofrecen referencias más robustas, porque no dependen de esos extremos. Para
anomalías que solo se ven al combinar varias columnas, IsolationForest o
LocalOutlierFactor pueden ayudarte a priorizar qué filas revisar. Sus
puntuaciones tampoco demuestran que una observación sea errónea. Demuestran
que es poco habitual bajo el criterio del algoritmo.
Si decides recortar valores por percentiles, estima los límites dentro del entrenamiento de cada pliegue y aplica esos mismos límites a la validación. Calcular el percentil 99 con todos los datos, y luego recortar la prueba con ese umbral, filtra la prueba con información que no debería haber visto. Documenta cuántas observaciones modificas y si el recorte afecta más a unos grupos que a otros.
Paso 8: compara predictores con el objetivo
El gráfico apropiado depende del tipo de las dos variables, no de cuál separe más a primera vista. Si comparas una cantidad con una clase, sirven cajas, histogramas o ECDF por clase: quieres ver si la distribución se desplaza, no solo si cambia la media. Si comparas dos categorías, una tabla de contingencia con tasas y denominadores. Si comparas dos cantidades, un diagrama de dispersión; cuando los puntos se tapan, usa transparencia, agregación o una densidad por hexágonos.
Es fácil quedarse con el gráfico que más separa las clases y presentar solo ese. Un predictor que no separa también es un hallazgo, y uno que separa mucho merece la pregunta de si estará disponible al predecir.
tasas = train.groupby("plan").abandono_30d.agg(["sum", "count", "mean"]).reindex(planes)# Wilson: intervalos puntuales aproximados al 95 % para proporciones.z = stats.norm.ppf(0.975)p, m = tasas["mean"], tasas["count"]centro = (p + z**2 / (2 * m)) / (1 + z**2 / m)radio = z * np.sqrt(p * (1 - p) / m + z**2 / (4 * m**2)) / (1 + z**2 / m)tasas["inferior"], tasas["superior"] = centro - radio, centro + radiofig, axs = plt.subplots(1, 2, figsize=(11, 4), layout="constrained")axs[0].boxplot( [train.loc[train.abandono_30d == y, "incidencias_30d"] for y in [0, 1]], tick_labels=["Permanece", "Abandona"],)axs[0].set(ylabel="Incidencias en 30 días", title="Numérica frente a clase")axs[1].errorbar( np.arange(len(tasas)), p * 100, yerr=np.vstack([p - tasas.inferior, tasas.superior - p]) * 100, fmt="o", color=AZUL, capsize=5,)axs[1].set( xticks=np.arange(len(tasas)), xticklabels=[f"{plan}\nn={n}" for plan, n in zip(tasas.index, m)], ylabel="Abandono (%)", title="Tasa e intervalo de Wilson (95 %)",)guardar(fig, "05-relaciones-objetivo.webp")print(tasas.round(3).to_string())resultados["tasas_por_plan"] = tasas.round(4).to_dict(orient="index")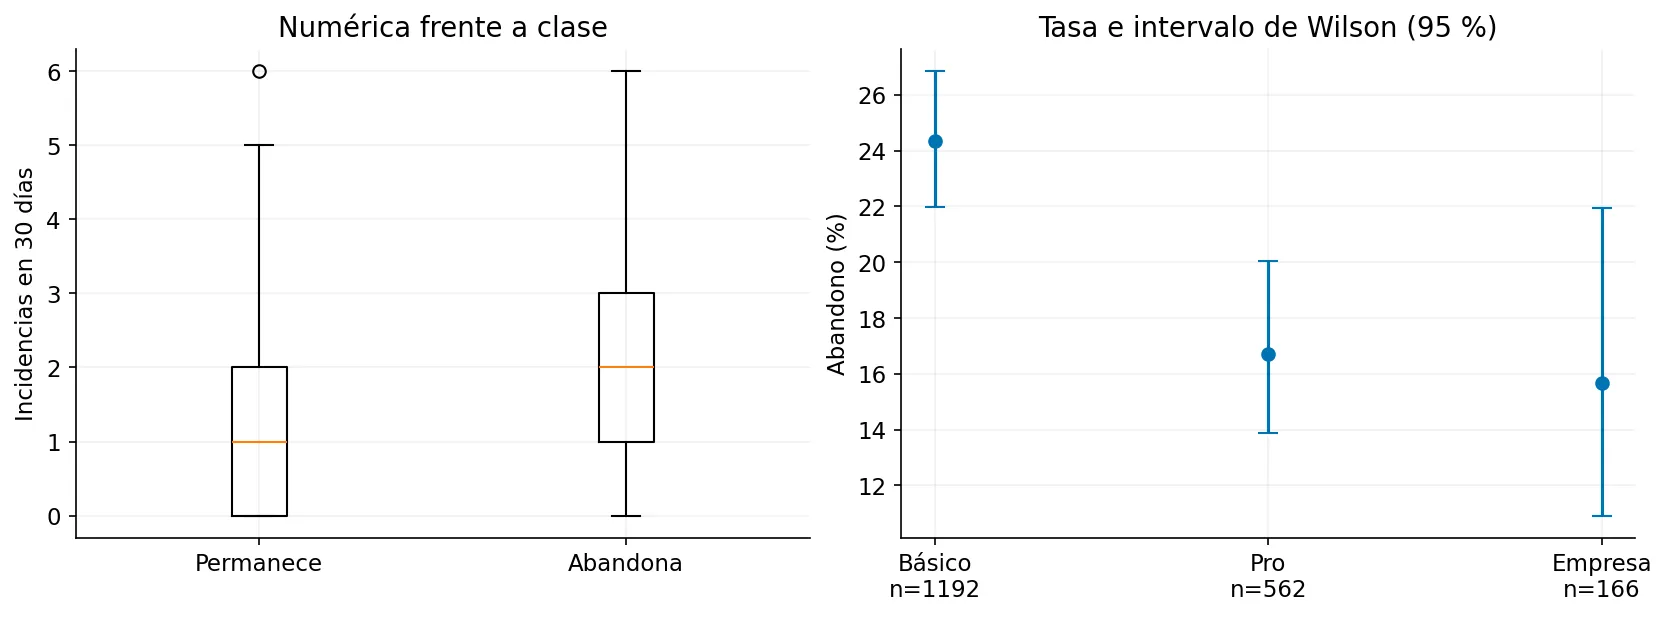
La distribución de incidencias de quienes abandonan se desplaza hacia valores más altos, pero las dos cajas se solapan. Eso es lo que cabe esperar de una asociación útil y no determinista. Saber que un cliente tuvo muchas incidencias aumenta la expectativa de abandono. No autoriza a afirmar que abandonará, ni a prometer que reducir las incidencias evitará un número concreto de bajas. Esa segunda afirmación es causal, y este gráfico no la sostiene: las incidencias y el abandono pueden compartir una causa que no está en la tabla.
El segundo panel contiene estas tasas:
| Plan | Clientes | Abandonos | Tasa | Intervalo de Wilson del 95 % |
|---|---|---|---|---|
| Básico | 1192 | 290 | 24,33 % | 21,98–26,84 % |
| Pro | 562 | 94 | 16,73 % | 13,87–20,04 % |
| Empresa | 166 | 26 | 15,66 % | 10,92–21,96 % |
No compares solo el número de abandonos. Básico tiene 290 y Empresa 26, pero Básico también tiene muchos más clientes. La tasa divide abandonos entre clientes del plan y hace comparable lo que los conteos no pueden comparar. La diferencia entre Básico y Pro es de 7,60 puntos porcentuales (24,33 − 16,73). No la llames «un aumento del 7,60 %». Esa expresión es relativa: el 7,60 % de la tasa de Pro son unos 1,3 puntos (0,076 × 16,73), no los 7,60 que separan los planes. En términos relativos, 24,33 / 16,73 − 1 es aproximadamente un 45 %: la tasa de Básico es cerca de un 45 % mayor que la de Pro. Las dos cuentas son correctas y no se sustituyen.
Las barras son intervalos de Wilson al 95 %. Responden a una pregunta frecuentista, no a la que el lenguaje cotidiano les atribuye. Si repitieras el muestreo muchas veces y en cada muestra construyeras el intervalo con este mismo procedimiento, aproximadamente el 95 % de esos intervalos contendría la tasa de la población, bajo los supuestos del método. La barra de esta muestra concreta no «tiene un 95 % de probabilidad de contener la tasa verdadera». Y no corrige sesgos de selección ni de medición: si la muestra está mal tomada, el intervalo será estrecho alrededor de la respuesta equivocada.
Se usa Wilson, y no el intervalo clásico p ± 1,96 √(p(1−p)/n), porque este
último se apoya en una aproximación normal que falla con muestras pequeñas o
con proporciones cercanas a 0 o a 1: puede salirse del intervalo [0, 1] y su
cobertura real se aleja del 95 % nominal. Wilson se queda dentro de [0, 1] y
se comporta mejor en esos casos. Aquí Empresa no es un caso extremo, pero su
barra es la más ancha porque tiene menos clientes. Con 166 observaciones,
unos pocos abandonos de más o de menos mueven la tasa varios puntos; con
1192, la misma diferencia apenas se nota. Por eso un grupo pequeño puede
parecer muy distinto en una ejecución y ordinario en la siguiente. El tamaño
muestral forma parte del resultado, no es una nota al pie.
Estos intervalos son puntuales: cada uno se calcula como si fuera la única comparación. No constituyen un ajuste simultáneo por todas las comparaciones que podrías haber explorado. El solapamiento visual de dos barras tampoco sustituye una estimación de la diferencia entre esas dos tasas. Dos intervalos pueden solaparse y la diferencia seguir siendo de interés, o no solaparse y carecer de importancia práctica, según la pregunta que hagas. Si un cliente aparece varias veces, las observaciones ya no son independientes y el intervalo se vuelve optimista. Si comparas docenas de segmentos y enseñas el que más destaca, tienes que tratar la multiplicidad antes de presentar el hallazgo como confirmado.
Paso 9: examina correlaciones y busca lo que ocultan
La correlación resume, en un solo número, un tipo concreto de relación entre dos variables. No resume «si tienen algo que ver». Pearson mide asociación lineal: hasta qué punto los puntos se alinean con una recta. Spearman aplica esa misma idea a los rangos, y por eso recoge relaciones monótonas, aquellas en las que una variable tiende a subir o a bajar cuando la otra sube, aunque la subida no sea una recta. Cuando están definidas, ambas suelen caer entre −1 y 1. Una variable constante no tiene correlación informativa: si nada varía, no hay asociación que medir, y el cálculo devuelve un valor ausente.
variables = ["antiguedad_meses", "sesiones_30d", "incidencias_30d", "gasto_mensual", "gasto_anual_estimado"]etiquetas = ["Antigüedad", "Sesiones", "Incidencias", "Gasto/mes", "Gasto/año"]corr = train[variables].corr(method="spearman")fig, ax = plt.subplots(figsize=(7, 6), layout="constrained")im = ax.imshow(corr, vmin=-1, vmax=1, cmap="RdBu_r")ax.set(xticks=range(5), yticks=range(5), xticklabels=etiquetas, yticklabels=etiquetas, title="Correlación de Spearman entre predictores")plt.setp(ax.get_xticklabels(), rotation=35, ha="right")ax.grid(False)for i in range(5): for j in range(5): ax.text(j, i, f"{corr.iloc[i, j]:.2f}", ha="center", va="center", color="white" if abs(corr.iloc[i, j]) > 0.6 else "black")fig.colorbar(im, ax=ax, shrink=0.8)guardar(fig, "06-correlaciones.webp")print("Correlación gasto mensual/anual:", corr.loc["gasto_mensual", "gasto_anual_estimado"])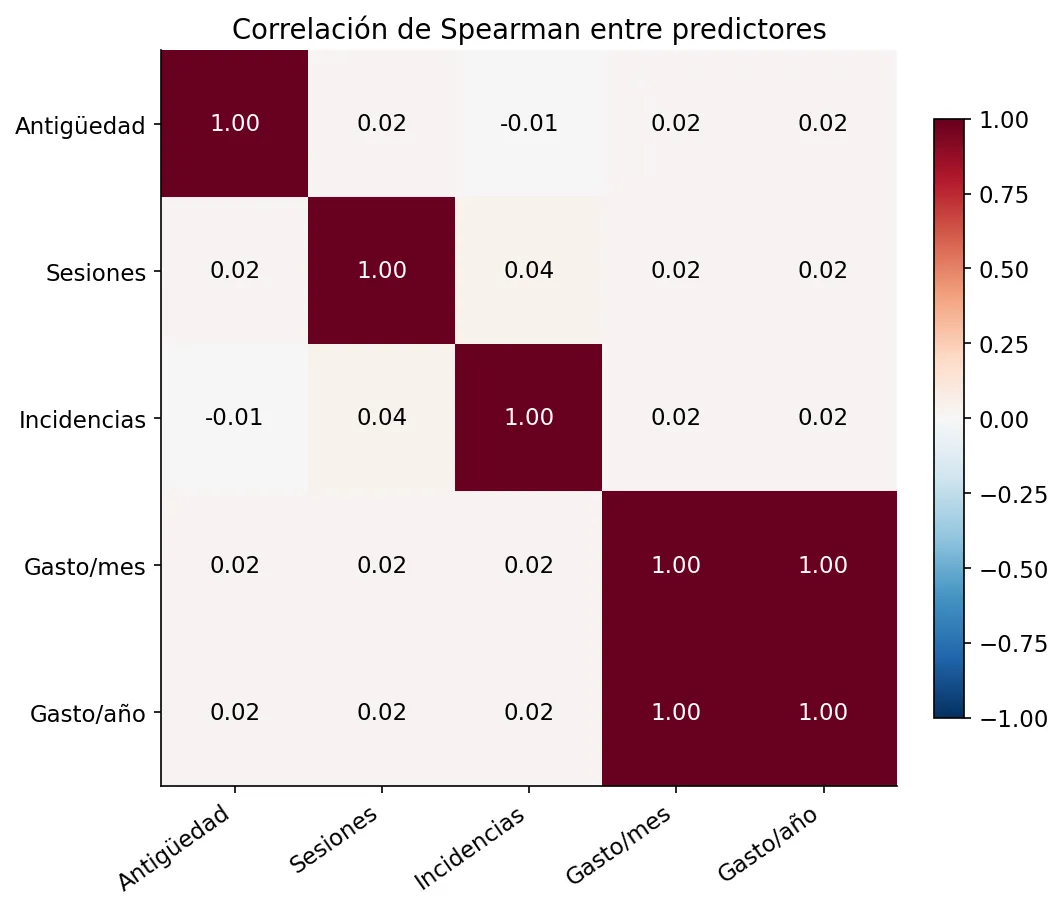
Los gastos mensual y anual tienen correlación prácticamente 1 porque el segundo es doce veces el primero, salvo redondeo. No es una relación del negocio: es una columna calculada a partir de la otra. Conservar las dos no añade información y sí estorba. En una regresión sin restricciones, los coeficientes se reparten de forma inestable entre columnas redundantes, y dejas de poder decir qué variable pesa más. En el ejemplo posterior eliminamos la columna anual. En otros conjuntos, una correlación alta no basta para borrar una columna. Investiga la definición y la calidad de ambas mediciones. A veces las dos columnas miden lo mismo con errores distintos, y conviene quedarse con la más fiable, no con la primera que aparece.
El color usa la misma escala de −1 a 1 en todas las celdas, para que un rojo intenso signifique lo mismo en cualquier sitio de la matriz. La diagonal vale 1 por definición, siempre que la variable no sea constante. No es un hallazgo: es la correlación de cada columna consigo misma. Además, pandas calcula estas correlaciones con los pares disponibles. Si cada columna tiene ausencias distintas, dos celdas de la misma matriz pueden apoyarse en muestras diferentes. Antes de comparar dos coeficientes, revisa cuántos pares completos sostienen cada uno.
Una correlación cercana a cero no implica independencia. Independencia
significa que conocer una variable no cambia lo que sabes de la otra.
Correlación nula significa algo mucho más estrecho: que no hay asociación
lineal o, en el caso de Spearman, monótona. El ejemplo siguiente, separado
del caso de clientes, genera una relación en U. Valores de x muy negativos
o muy positivos producen valores grandes de y.
rng_curva = np.random.default_rng(12)x = np.linspace(-3, 3, 500)y_curva = x**2 + rng_curva.normal(0, 0.4, len(x))pearson = stats.pearsonr(x, y_curva).statisticspearman = stats.spearmanr(x, y_curva).statisticfig, ax = plt.subplots(figsize=(8, 4), layout="constrained")ax.scatter(x, y_curva, s=12, alpha=0.5, color=AZUL)ax.set(xlabel="x", ylabel="y", title=f"Relación en U: Pearson={pearson:.3f}; Spearman={spearman:.3f}")guardar(fig, "07-no-lineal.webp")resultados["curva"] = {"pearson": float(pearson), "spearman": float(spearman)}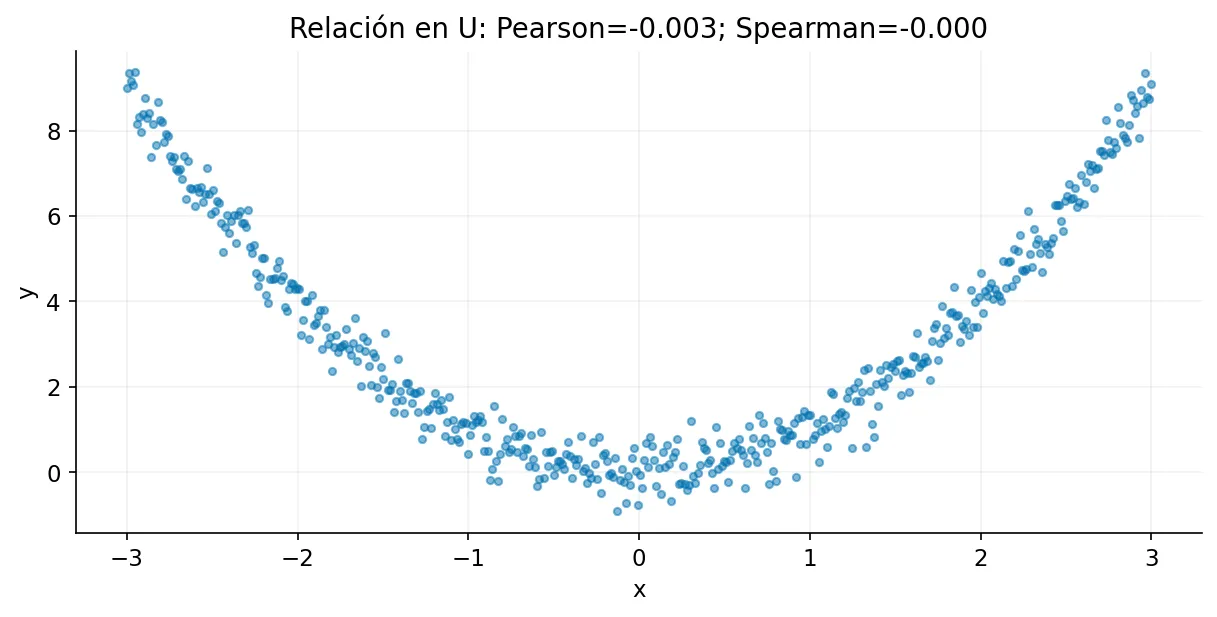
Pearson vale aproximadamente −0,003 y Spearman aproximadamente 0. La
relación es evidente en el gráfico e invisible para las dos correlaciones,
porque no es lineal ni monótona: al pasar de x negativo a x positivo,
y primero baja y después sube. Los aumentos y las disminuciones se
cancelan en el resumen. Un filtro que elimine toda variable con correlación
pequeña descartaría x, que es la única que contiene información sobre y.
Si vas a buscar curvas, interacciones o estimadores de información mutua,
hazlo dentro de un proceso de validación. Una sola estadística no es un
detector universal de utilidad.
Tampoco concluyas causalidad a partir de una asociación. Tres historias
distintas producen el mismo coeficiente. Una tercera variable puede empujar
a las dos. El sentido temporal puede ser el contrario del que supones: quizá
la expectativa de abandono reduce las sesiones, y no al revés. O el propio
muestreo puede inducir el patrón, como verás con la paradoja de Simpson en
el paso siguiente. La referencia de pearsonr de SciPy
incluye ejemplos de dependencia que una correlación nula no descarta.
Paso 10: explora segmentos y proyecciones multivariables
Una relación agregada puede cambiar, e incluso invertirse, al separar grupos. El ejemplo clásico es la paradoja de Simpson. Imagina dos campañas evaluadas en clientes nuevos y antiguos. Los números son pequeños a propósito, para que puedas rehacer la cuenta:
| Segmento | Campaña A | Campaña B |
|---|---|---|
| Nuevos | 9 conversiones de 10: 90 % | 80 de 100: 80 % |
| Antiguos | 20 de 100: 20 % | 1 de 10: 10 % |
| Total | 29 de 110: 26,4 % | 81 de 110: 73,6 % |
Recorre la tabla en los dos sentidos. Entre los nuevos, A convierte el 90 % y B el 80 %. Entre los antiguos, A convierte el 20 % y B el 10 %. En cada segmento, A es mejor. Al sumar, B convierte el 73,6 % y A solo el 26,4 %. No hay un error aritmético. B fue asignada sobre todo a clientes nuevos, que convierten más hagan lo que hagan, y A fue asignada sobre todo a clientes antiguos. El total mezcla el efecto de la campaña con el efecto de a quién se la ofreciste.
Antes de recomendar una campaña tienes que estudiar la asignación. Ni el total ni las tablas segmentadas identifican por sí solos un efecto causal. Segmentar por una variable que es consecuencia de la campaña, y no una característica previa, puede inventar la paradoja en el otro sentido. La lección para el EDA es más modesta, y más útil. No te quedes con el agregado si un grupo relevante puede tener otra tasa. Y no te quedes con el segmento si el agregado esconde que los grupos no eran comparables.
Para explorar varias columnas numéricas a la vez puedes usar PCA, el análisis de componentes principales. PCA busca direcciones nuevas, combinaciones lineales de las columnas originales, ordenadas por cuánta varianza capturan. La primera componente es la dirección en la que los puntos más se estiran. La segunda es la dirección de mayor estiramiento entre las que quedan, perpendicular a la primera. No busca separar clases. Ni siquiera mira la etiqueta mientras construye los ejes.
Aquí imputamos y estandarizamos cuatro predictores del entrenamiento antes de proyectarlos a dos dimensiones. Estandarizar importa. Sin ese paso, la columna con las unidades más grandes —el gasto, frente a un conteo de incidencias— dominaría la dirección de máxima varianza por una cuestión de escala, no de estructura. Restar la media y dividir por la desviación estándar pone las cuatro columnas en una escala comparable antes de preguntar por dónde se extienden.
numericas = ["antiguedad_meses", "sesiones_30d", "incidencias_30d", "gasto_mensual"]proyeccion = Pipeline([ ("imputar", SimpleImputer(strategy="median")), ("escalar", StandardScaler()), ("pca", PCA(n_components=2)),])coords = proyeccion.fit_transform(train[numericas])varianza = proyeccion.named_steps["pca"].explained_variance_ratio_fig, ax = plt.subplots(figsize=(8, 5), layout="constrained")for clase, color, marca, nombre in [(0, AZUL, "o", "Permanece"), (1, NARANJA, "^", "Abandona")]: mascara = train.abandono_30d.to_numpy() == clase ax.scatter(coords[mascara, 0], coords[mascara, 1], s=16, alpha=0.35, c=color, marker=marca, label=nombre)ax.set(xlabel=f"PC1 ({varianza[0]:.1%})", ylabel=f"PC2 ({varianza[1]:.1%})", title="PCA de cuatro predictores numéricos")ax.legend()guardar(fig, "08-pca.webp")resultados["pca_varianza_pct"] = (varianza * 100).round(2).tolist()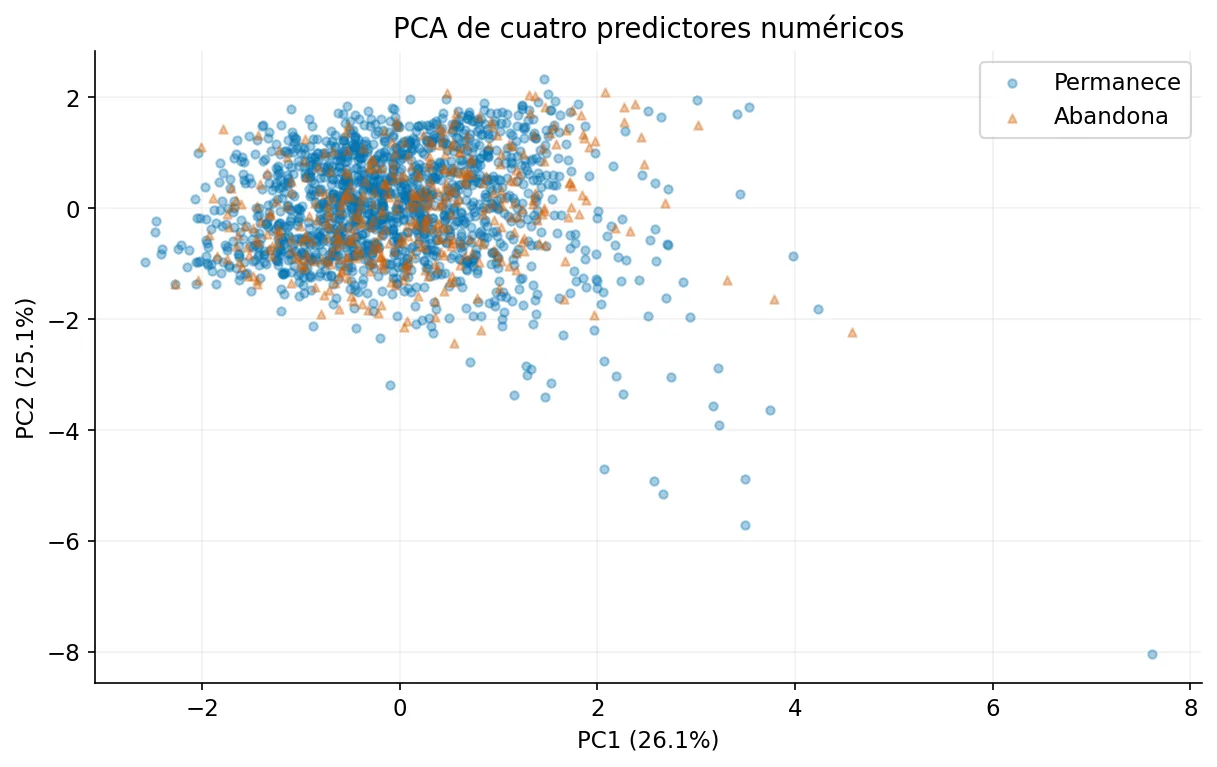
El primer eje conserva el 26,08 % de la varianza y el segundo el 25,05 %. Juntos muestran aproximadamente el 51,13 % de la variación estandarizada. Casi la mitad de lo que estas cuatro columnas varían no está en la figura. Leer el gráfico como si fuera el espacio completo es el error típico de una proyección: lo que se solapa en dos dimensiones puede separarse en la tercera o en la cuarta.
El solapamiento de las dos clases tampoco demuestra que el problema sea impredecible. PCA orienta los ejes hacia donde más varían los predictores, no hacia donde mejor se separan quienes abandonan de quienes se quedan. Una dirección muy informativa para la etiqueta puede ser, en varianza, una dirección menor, y quedar fuera de este plano. Los colores y los símbolos se añaden después de ajustar la proyección, solo para que puedas mirar. Este PCA es una vista descriptiva. No entra en el clasificador.
Si más adelante probaras PCA como transformación del modelo, tendrías que ajustarlo dentro de cada pliegue. Si lo ajustas con todos los datos y luego partes, la prueba ha participado en definir los ejes. La implementación de PCA de scikit-learn centra las variables, pero no las escala: por eso el pipeline lo hace antes.
Una figura de UMAP o de t-SNE puede ayudarte a inspeccionar vecindarios, con una advertencia más fuerte que la de PCA. Esas técnicas están pensadas para preservar cercanías locales, no distancias globales. Una isla en el gráfico no es, por sí misma, un grupo real: puede ser un efecto del número de vecinos, de la semilla o de la escala. Cambia semillas y parámetros, mira si el dibujo se sostiene y vuelve siempre a las variables originales para nombrar lo que crees ver. En agrupamiento, comprueba además tamaños, interpretabilidad y sensibilidad al escalado. Un valor alto de una métrica interna —la silueta, la inercia— dice que los grupos son compactos bajo esa métrica. No dice que sean segmentos útiles para una decisión.
Paso 11: reconoce tendencias y cambios temporales
Cuando los registros tienen fecha, el tiempo no es una columna más. Es el orden en el que la información llega, y ese orden decide qué puedes usar para predecir. Empieza por lo que parece administrativo, que es donde se esconden los fallos: orden, frecuencia, duplicados temporales, huecos, zonas horarias y cambios de definición. Una serie que salta cada lunes puede ser estacionalidad, o puede ser que el lunes se consolidan tres días de un sistema que no trabaja en fin de semana. Solo el diccionario de datos distingue las dos historias.
Después mira cuatro patrones que suelen convivir. La tendencia es el movimiento lento: crecimiento o caída a lo largo de meses. La estacionalidad es un ciclo que se repite con un periodo conocido, como la semana o el año. Un ciclo más irregular no tiene periodo fijo. Un cambio de nivel es un salto que se mantiene, a menudo ligado a un evento: una campaña, un cambio de precio, o una modificación de cómo se cuenta.
Este ejemplo es independiente del conjunto de clientes. Simula 180 días de pedidos, con crecimiento, un ciclo semanal, ruido y un salto de nivel en el día 120. No es una evaluación de pronóstico. Toda la figura es una exploración de un histórico de desarrollo: aquí está permitido mirar la serie entera, precisamente porque no vas a puntuar un modelo con ella.
rng_tiempo = np.random.default_rng(7)fechas = pd.date_range("2025-01-01", periods=180, freq="D")t = np.arange(len(fechas))serie = pd.Series( 100 + 0.12 * t + 15 * np.sin(2 * np.pi * t / 7) + 25 * (t >= 120) + rng_tiempo.normal(0, 4, len(t)), index=fechas, name="pedidos",)fig, axs = plt.subplots(1, 2, figsize=(12, 4), layout="constrained")axs[0].plot(serie.index, serie, alpha=0.45, color=AZUL, label="Diario")axs[0].plot(serie.index, serie.rolling(7).mean(), color="black", label="Media de 7 días")axs[0].axvline(serie.index[120], color=NARANJA, linestyle="--", label="Cambio simulado")axs[0].set(ylabel="Pedidos simulados", title="Tendencia, ciclo semanal y cambio de nivel")axs[0].tick_params(axis="x", rotation=30)axs[0].legend(fontsize=9)axs[1].ecdf(serie.iloc[:90], label="Primeros 90 días", color=AZUL)axs[1].ecdf(serie.iloc[90:], label="Últimos 90 días", color=NARANJA)axs[1].set(xlabel="Pedidos", ylabel="Proporción acumulada", title="Comparación descriptiva de periodos")axs[1].legend()guardar(fig, "09-tiempo.webp")# Variables para predecir el día t: usan exclusivamente días anteriores.historico = pd.DataFrame({ "objetivo": serie, "retardo_1": serie.shift(1), "media_previa_7": serie.shift(1).rolling(7).mean(),})assert pd.isna(historico.media_previa_7.iloc[6])assert np.isclose(historico.media_previa_7.iloc[7], serie.iloc[:7].mean())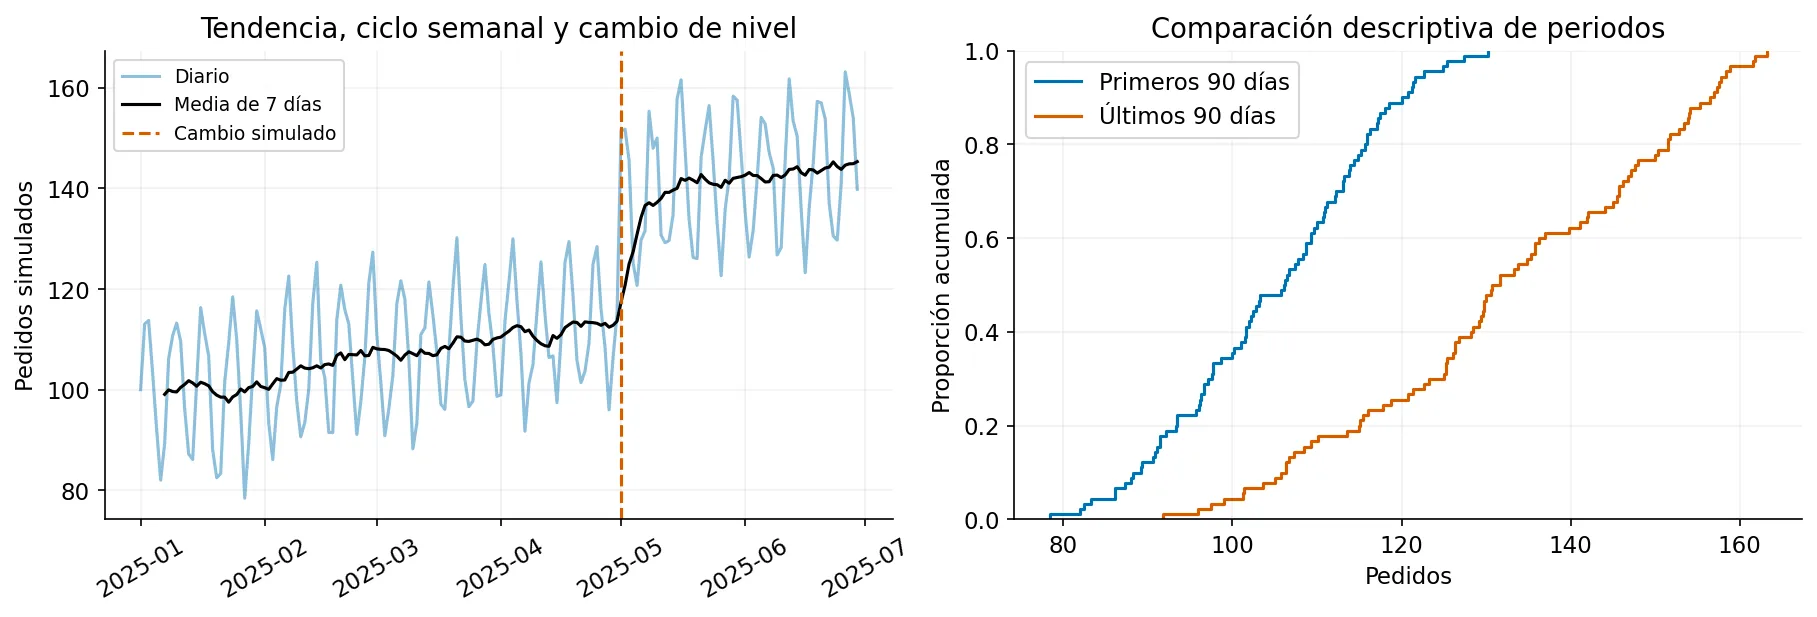
La media móvil de siete días suaviza el ciclo semanal y deja ver el aumento de nivel. Promedia cada día con sus vecinos, así que una oscilación que sube y baja dentro de la semana se cancela, y queda el movimiento más lento. En la ECDF, la curva del segundo periodo se desplaza hacia la derecha: para una misma fracción acumulada necesitas un número mayor de pedidos. Eso describe un cambio entre periodos. No identifica la causa. Podría ser demanda, una campaña o un cambio de medición: alguien redefinió qué cuenta como pedido y la serie creció sin que creciera el negocio. Esa última posibilidad conviene descartarla antes de interpretar la subida.
Para predecir el día t, la media de los siete días anteriores se construye
con shift(1).rolling(7).mean(). El shift(1) retira el propio día antes de
promediar. Los dos assert del código son la comprobación. En el índice 6,
el séptimo día de la serie, todavía no hay siete días anteriores completos,
y la media es ausente. En el índice 7 la media coincide con la de los índices
0 a 6, los siete primeros días, y no incluye el índice 7, que es el día que
se quiere predecir. Si omites el shift y usas la media móvil que incluye
el propio día t, una parte del objetivo entra en el predictor: el modelo ve,
disfrazado de «media reciente», el valor que se supone que debe anticipar.
Una media móvil válida para describir el pasado puede ser inválida como
característica de un pronóstico. La diferencia no está en la fórmula del
promedio, sino en qué fechas entran en la ventana.
La autocorrelación compara la serie con una copia desplazada de sí misma. Si el valor de hoy se parece al de hace siete días, la autocorrelación en el retardo 7 será alta. Picos en los retardos 7, 14 y 21 orientan hacia una periodicidad semanal, pero una tendencia también induce autocorrelación: si la serie sube de forma continua, hoy se parece a ayer por el crecimiento, no por un ciclo. Revisa el gráfico original y la frecuencia de muestreo antes de interpretar una ACF o una descomposición STL. El módulo temporal de statsmodels incluye estas herramientas.
En producción distingue tres cambios que a menudo se nombran igual y no lo
son. Puede cambiar la distribución de los predictores. Puede cambiar la
prevalencia del objetivo. Y puede cambiar la relación entre predictores y
objetivo. Ver que X se ha movido no demuestra que el modelo haya empeorado:
quizá la relación se mantiene y solo ha cambiado el tráfico. Para saberlo
necesitas etiquetas, cuando lleguen, y métricas calculadas por periodo. Las
pruebas de dos muestras, aplicadas fila a fila, tampoco miden la importancia
práctica del cambio, y la dependencia temporal invalida sus supuestos: dos
días seguidos no son dos extracciones independientes.
Paso 12: adapta el análisis a una regresión
Si el objetivo es un precio, una duración o una cantidad, el EDA cambia de aspecto pero no de lógica. Estudia primero el rango, las unidades, los ceros, los límites de medición y las colas. Un contador que no puede pasar de 100, un precio que no puede ser negativo o una duración registrada en minutos enteros son restricciones del problema, no detalles de formato. Y desconfía de un error medio único: puede ocultar que el modelo falla justo en los valores altos, que son los que más importan.
El ejemplo siguiente, también independiente, genera superficies y precios de viviendas ficticias. La relación media es una recta: cada metro cuadrado añade, en promedio, la misma cantidad al precio. Pero la dispersión del precio crece con la superficie. Una vivienda pequeña se desvía poco de la recta; una grande puede desviarse mucho. Después ajustamos una regresión simple y miramos sus errores en un subconjunto de validación, no en los mismos datos con los que se estimó la recta. Ajustar y juzgar sobre las mismas filas haría que el modelo pareciera mejor de lo que es.
rng_reg = np.random.default_rng(21)superficie = rng_reg.uniform(30, 180, 600)precio = 50000 + 1800 * superficie + rng_reg.normal(0, 450 * superficie)X_reg = superficie.reshape(-1, 1)Xa, Xv, ya, yv = train_test_split(X_reg, precio, test_size=0.25, random_state=42)reg = LinearRegression().fit(Xa, ya)pred = reg.predict(Xv)residuos = yv - predfig, axs = plt.subplots(1, 2, figsize=(11, 4), layout="constrained")axs[0].scatter(superficie, precio / 1000, s=12, alpha=0.45, color=AZUL)axs[0].set(xlabel="Superficie (m²)", ylabel="Precio (miles de unidades)", title="Datos sintéticos: variabilidad creciente")axs[1].scatter(pred / 1000, residuos / 1000, s=18, alpha=0.55, color=AZUL)axs[1].axhline(0, color="black", linestyle="--")axs[1].set(xlabel="Predicción (miles)", ylabel="Residuo (miles)", title="Residuos en validación")guardar(fig, "10-regresion.webp")resultados["regresion_mae"] = round(float(mean_absolute_error(yv, pred)), 2)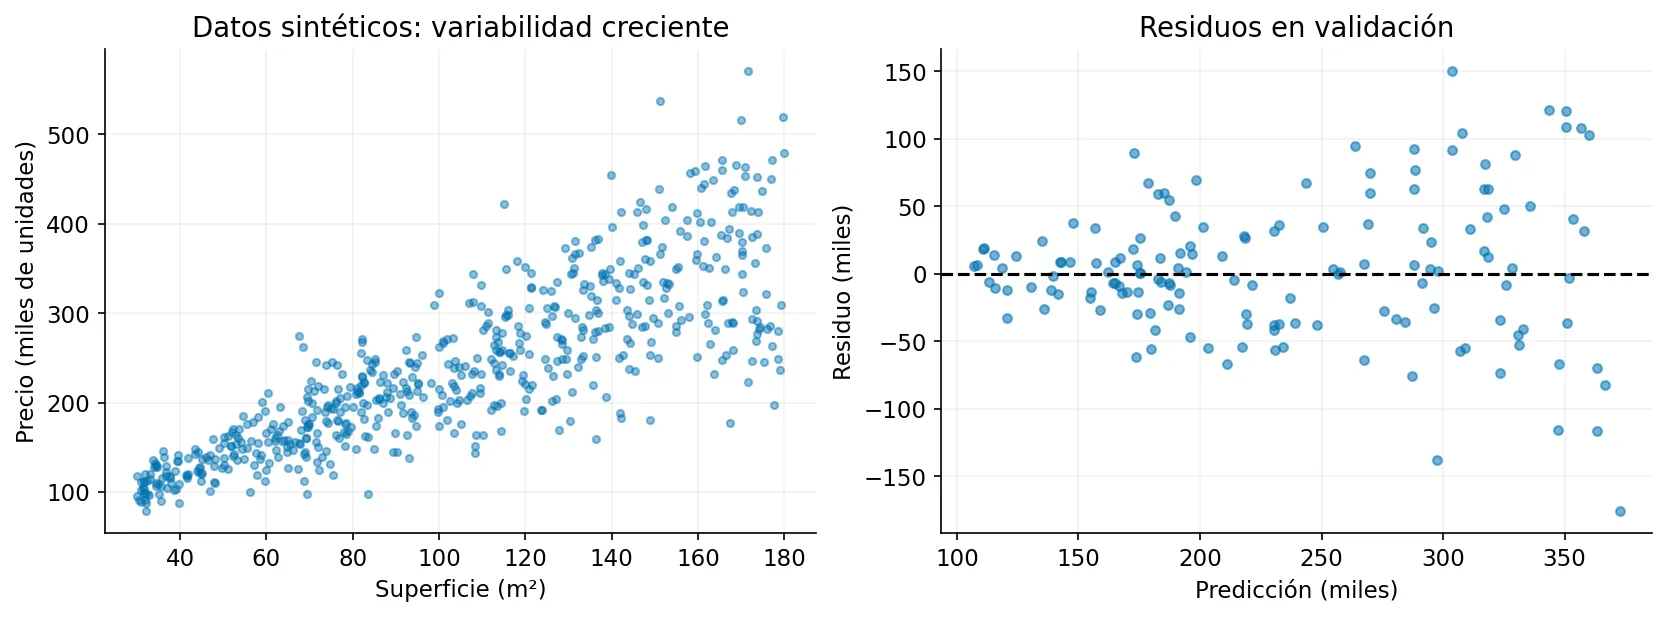
Un residuo es el valor observado menos la predicción. En el panel derecho, un residuo positivo significa que el modelo se quedó corto; uno negativo, que se pasó. No leas los residuos como una lista de fallos sueltos. Léelos como una nube, y busca tres patrones.
- Una curva alrededor de cero sugiere que la forma de la relación no está bien representada. La recta deja un resto sistemático: por ejemplo, subestima los valores medios y sobreestima los extremos. Hace falta otra forma, no solo otro coeficiente.
- Una apertura en abanico sugiere heterocedasticidad: la variabilidad del error cambia con el nivel de la predicción. El modelo acierta en media en todos los tramos, pero su incertidumbre no es la misma. Un intervalo de anchura constante sería demasiado ancho para los casos pequeños y demasiado estrecho para los grandes.
- Unos puntos aislados pueden ser errores de captura, casos difíciles o subpoblaciones que el modelo no representa. Un residuo enorme no se borra. Se investiga.
Aquí la variabilidad creciente se introdujo en la simulación y se aprecia en la figura. El error absoluto medio en validación es de aproximadamente 38 345,46 unidades monetarias. Ese número, solo, no dice si el modelo sirve. Hay que compararlo con una referencia —¿qué error comete quien siempre predice la mediana?— y con la tolerancia del problema. Equivocarse en 38 000 puede ser inaceptable en una tasación y tolerable en otra escala. El tamaño aislado de una métrica no es un veredicto.
El MAE, mean absolute error, promedia las magnitudes absolutas de los errores. En la suma, un error de 10 000 pesa lo mismo que diez errores de 1 000. El RMSE, root mean squared error, eleva los errores al cuadrado antes de promediar, así que penaliza más los errores grandes, y al final toma la raíz para volver a las unidades del objetivo. Ninguno sustituye al otro. Evalúa también por segmentos o por rangos de precio: un MAE aceptable puede esconder un error sistemático en las viviendas grandes.
Un objetivo estrictamente positivo puede beneficiarse de una transformación logarítmica, que convierte errores relativos en errores aditivos. Pero eso cambia qué errores priorizas: un modelo ajustado en logaritmos se preocupa por el porcentaje, no por la diferencia en dinero. Invertir la transformación —exponenciar la predicción— no recupera automáticamente la media condicional en la escala original. Recupera otra cosa, más cercana a una mediana si el error en logaritmos es simétrico, y hace falta una corrección si lo que prometiste fue la media.
Este diagnóstico es una continuación del EDA después de ajustar una referencia. Sirve para decidir qué probar a continuación. Si usas los residuos para elegir variables o modelos nuevos, esa muestra ya es validación: ha participado en tus decisiones. No la presentes después como una prueba final intacta.
Paso 13: convierte los hallazgos en un pipeline evaluable
Volvamos al abandono, ya con una lista de decisiones y no solo de impresiones. Los hallazgos sugieren conservar la antigüedad, las sesiones, las incidencias, el gasto y el plan; imputar las numéricas; añadir indicadores de ausencia; y codificar el plan mediante one-hot, una columna indicadora por categoría. Excluimos el identificador, el gasto anual redundante y el reembolso posterior.
Conviene detenerse en el one-hot, porque es la respuesta concreta al problema
del paso 1. En lugar de asignar 1, 2 y 3 a los planes, se crean columnas que
valen 1 o 0. Ningún plan queda «entre» otros dos, y el modelo puede asignar
a cada uno su propio efecto. handle_unknown="ignore" evita que una
categoría nueva, ausente del entrenamiento, rompa la predicción: sus
indicadores quedan en cero y el resto del modelo sigue funcionando.
La exclusión del reembolso se basa en cuándo se conoce, no en cuánto se correlaciona con la etiqueta. Esta distinción es la que más modelos aparentemente brillantes echa a perder. Una fuga puede sobrevivir a una validación cruzada bien programada si la variable ilícita está presente en todos los pliegues: el procedimiento es correcto y la variable no lo es. Revisa también acumulados calculados después del evento, tablas unidas sin respetar fechas, y etiquetas codificadas de forma indirecta en nombres de archivo o en rutas. El reembolso de este ejemplo es una fuga obvia. Las que llegan a producción suelen ser más discretas.
Un Pipeline ata la preparación y el modelo para que la imputación, el
escalado y la codificación se vuelvan a ajustar dentro de cada pliegue,
usando solo las filas de ese pliegue. Sin esa atadura es fácil calcular la
mediana, o la media del escalado, con datos que la validación no debería
haber visto. Compáralo con la guía de errores habituales y fuga de información de scikit-learn.
El código usa regresión logística como referencia interpretable, sin búsqueda
de hiperparámetros. El objetivo de este paso es evaluar las decisiones del
EDA, no ganar una competición de modelos.
X = train[numericas + ["plan"]]y = train.abandono_30dpreparar = ColumnTransformer([ ("numericas", Pipeline([ ("imputar", SimpleImputer(strategy="median", add_indicator=True)), ("escalar", StandardScaler()), ]), numericas), ("categoricas", Pipeline([ ("imputar", SimpleImputer(strategy="most_frequent")), ("codificar", OneHotEncoder(handle_unknown="ignore")), ]), ["plan"]),])modelo = Pipeline([ ("preparar", preparar), ("clasificar", LogisticRegression(max_iter=2000)),])cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)metricas = {"roc_auc": "roc_auc", "ap": "average_precision", "accuracy": "accuracy"}evaluacion = {}for nombre, estimador in [ ("Referencia", DummyClassifier(strategy="prior")), ("Regresión logística", modelo),]: scores = cross_validate(estimador, X, y, cv=cv, scoring=metricas, n_jobs=1) evaluacion[nombre] = { metrica: f"{scores['test_' + metrica].mean():.3f} ± {scores['test_' + metrica].std():.3f}" for metrica in metricas }print(pd.DataFrame(evaluacion).T.to_string())# Cada probabilidad se obtiene sin entrenar con la fila correspondiente.prob_oof = cross_val_predict(modelo, X, y, cv=cv, method="predict_proba", n_jobs=1)[:, 1]precision, recall, _ = precision_recall_curve(y, prob_oof)fig, ax = plt.subplots(figsize=(8, 4), layout="constrained")ax.step(recall, precision, where="post", color=AZUL, label=f"AP OOF={average_precision_score(y, prob_oof):.3f}")ax.axhline(y.mean(), color=NARANJA, linestyle="--", label=f"Prevalencia={y.mean():.3f}")ax.set(xlabel="Exhaustividad (recall)", ylabel="Precisión (precision)", xlim=(0, 1), ylim=(0, 1.03), title="Predicciones fuera de pliegue en entrenamiento")ax.legend()guardar(fig, "11-precision-recall.webp")assert np.isfinite(prob_oof).all() and len(prob_oof) == len(train)resultados["validacion_cruzada"] = evaluacionresultados["oof"] = { "ap": round(float(average_precision_score(y, prob_oof)), 4), "roc_auc": round(float(roc_auc_score(y, prob_oof)), 4),}En los cinco pliegues de entrenamiento se obtuvo:
| Modelo | ROC AUC | Average precision | Exactitud |
|---|---|---|---|
| Referencia por prevalencia | 0,500 ± 0,000 | 0,214 ± 0,000 | 0,786 ± 0,000 |
| Regresión logística | 0,734 ± 0,049 | 0,469 ± 0,084 | 0,792 ± 0,022 |
Cada celda es la media ± la desviación estándar entre pliegues, redondeada a tres decimales. No es un intervalo de confianza. La desviación dice cuánto se mueve la métrica al cambiar el trozo de datos. Con cinco pliegues es una descripción pobre de la incertidumbre, pero basta para no tomar un 0,734 como si fuera exacto hasta la milésima.
Lee la tabla por columnas, empezando por la referencia. El
DummyClassifier(strategy="prior") asigna a todo el mundo la misma
probabilidad: la prevalencia. Como no ordena a nadie, el ROC AUC queda en
0,500. La exactitud es la de la clase mayoritaria, 0,786. La average
precision coincide con la prevalencia, 0,214. Esa fila no es un modelo
fallido. Es el suelo.
La regresión logística apenas mueve la exactitud, de 0,786 a 0,792, porque la regla trivial ya acertaba casi todo lo que la exactitud sabe premiar. ROC AUC mide otra cosa. Es la probabilidad de que, al tomar al azar un cliente que abandona y otro que no, el modelo asigne mayor puntuación al que abandona. Un valor de 0,5 es una ordenación sin información; 1 sería una ordenación perfecta. El 0,734 mejora la referencia, con una dispersión de ±0,049 entre pliegues. No te dice qué precisión tendrás en el umbral en el que de verdad vas a intervenir.
Average precision mira el mismo problema desde la precisión y la exhaustividad, y por eso es más sensible a la escasez de positivos. La referencia obtiene 0,214. La regresión logística sube a 0,469. Esa es la mejora que la exactitud escondía.
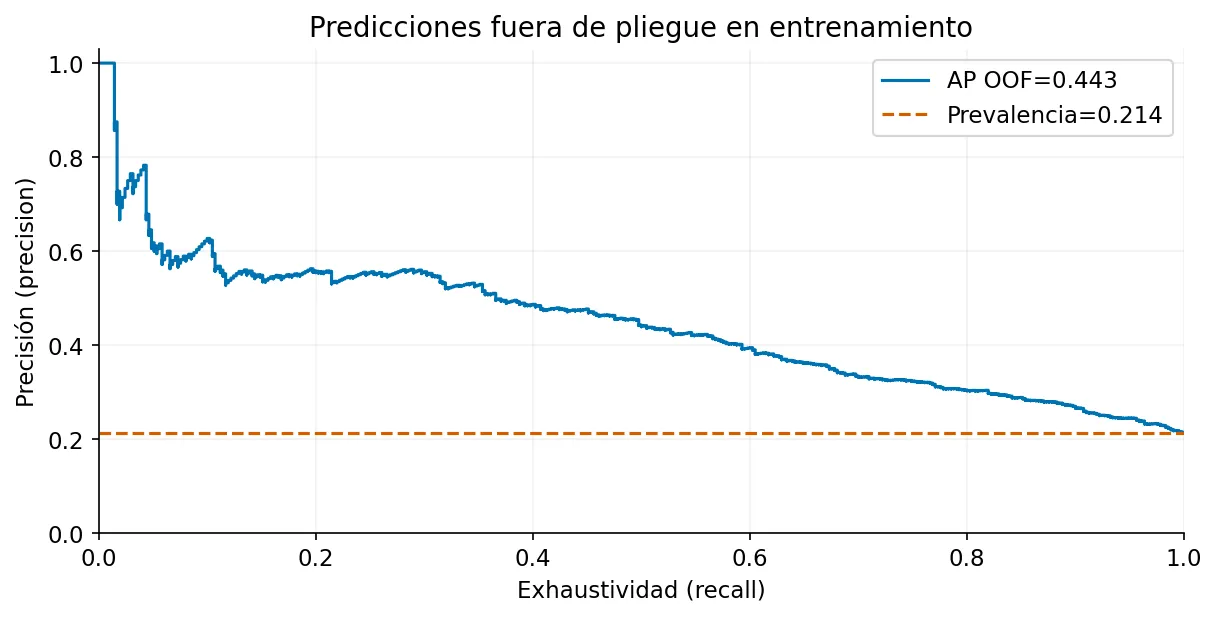
Cada probabilidad de esta curva se calculó con un modelo entrenado sin esa fila, mediante predicciones fuera de pliegue, u OOF por out of fold. No son las probabilidades del modelo ajustado sobre todo el entrenamiento, que serían optimistas: un modelo siempre se parece más a las filas que ya ha visto. Al recorrer la curva hacia la derecha aumentas la exhaustividad y, por lo general, aceptas más falsos positivos y pierdes precisión. La línea horizontal es la prevalencia. Representa lo que obtendrías, en expectativa, con una ordenación sin información. Un tramo de la curva que no supera esa línea no está aportando nada en ese punto de exhaustividad.
Average precision, abreviado AP, resume la curva ponderando la precisión por los incrementos de exhaustividad. No es necesariamente el área que obtendrías integrando la curva con trapecios: la definición de scikit-learn suma sobre los saltos de exhaustividad, y las dos cuentas pueden diferir. La AP de todas las predicciones OOF juntas es 0,443, distinta de la media de AP por pliegue, 0,469. Agregar predicciones y luego calcular la métrica no es lo mismo que calcular la métrica en cada pliegue y promediar. Cuando compares modelos, usa el mismo procedimiento en todos. No mezcles las dos cifras como si estimaran la misma cosa.
La curva sirve para discutir compromisos: cuánta precisión estás dispuesto a perder para detectar un abandono más. El umbral definitivo no se elige en el punto más alto de la curva. Se elige con costes y con capacidad operativa. Si solo puedes llamar a cincuenta clientes, el tramo relevante es el de exhaustividad baja y precisión alta, aunque el resto de la curva sea mediocre.
Si comparas muchas variantes sobre estos mismos pliegues —con logaritmo y sin él, con indicador y sin él, con otro modelo—, el ganador también se adapta a esos pliegues. Cada comparación gasta un poco de la independencia que la validación prometía. Las 480 filas de prueba siguen reservadas. Este tutorial no las usa para afirmar un rendimiento final, y tampoco deberían usarse para desempatar la quinta variante.
Como siguiente experimento podrías comparar el gasto original con log1p,
retirar el indicador de ausencia o probar un modelo no lineal. Son hipótesis
sugeridas por los gráficos, no mejoras garantizadas por la forma de un
histograma. La única forma de saber si ayudan es medirlas en validación,
contra la referencia que ya tienes.
Casos de uso frecuentes y herramientas apropiadas
La herramienta sigue a la pregunta y al tamaño de los datos, no al revés. Instalar cinco librerías antes de saber qué quieres mirar produce informes que no has pedido y gráficos que no sabes leer. Esta tabla amplía el caso tabular. No hace falta que instales todo: úsala para reconocer el tipo de problema y la familia de instrumentos que le corresponde.
| Caso | Qué explorar | Herramientas de Python | Cómo interpretar y actuar |
|---|---|---|---|
| Clasificación tabular | Clases, tasas por grupo, ausencias, disponibilidad temporal | pandas, Matplotlib o Seaborn; validación de scikit-learn | Contrasta con prevalencia y costes; evita variables posteriores al evento |
| Regresión | Objetivo, colas, dispersión, residuos y error por rango | pandas, scipy.stats, statsmodels, scikit-learn | Relaciona el error con las unidades y revisa curvatura o variabilidad creciente |
| Series temporales | Tendencia, ciclos, huecos, retardos y cambios de nivel | Índices temporales de pandas; ACF y STL de statsmodels | Conserva el orden temporal y evita ventanas que incorporen el futuro |
| Segmentación sin etiquetas | Escalas, redundancia, estabilidad y tamaño de grupos | PCA, K-means y DBSCAN de scikit-learn | Comprueba si los grupos se mantienen y tienen sentido en las variables originales |
| Anomalías o fraude | Colas, inconsistencias, extremos multivariables y grupos poco frecuentes | Reglas de dominio, IsolationForest, LocalOutlierFactor | Usa puntuaciones para revisión; no borres automáticamente los casos raros |
| Texto | Idioma, longitud, textos vacíos, duplicados y vocabulario por clase | pandas, expresiones regulares, CountVectorizer y TfidfVectorizer | Inspecciona ejemplos; separa autores o documentos relacionados y evita firmas que revelen la etiqueta |
| Imágenes | Resolución, canales, brillo, balance de clases y duplicados | Pillow, Matplotlib, OpenCV | Crea mosaicos por clase y fuente; evita dividir recortes de una misma imagen entre entrenamiento y prueba |
| Geografía | Coordenadas, cobertura, densidad, sistema de referencia y vecindad | GeoPandas, Shapely y mapas | Un grupo puede reflejar cobertura de captura; valida por bloques espaciales cuando corresponda |
| Millones de filas | Tipos, cardinalidad, agregaciones y cobertura de una muestra | Polars, DuckDB, formatos columnares como Parquet | Calcula resúmenes sobre todos los datos cuando sea viable y muestrea gráficos sin perder grupos raros |
| Inventario rápido de tablas | Tipos, ausencias, duplicados y asociaciones iniciales | ydata-profiling | Utiliza el informe para priorizar preguntas; sus alertas no conocen el dominio ni prueban causalidad |
Para la mayoría de las tareas tabulares bastan pandas y Matplotlib. Seaborn
añade, sobre esa misma base, comparaciones estadísticas con menos código:
histplot, ecdfplot, boxplot, scatterplot y heatmap calculan el
resumen y el gráfico juntos. Esa comodidad tiene un límite. Un pairplot de
cincuenta columnas dibuja una matriz de más de mil paneles. Nadie los lee.
Selecciona variables por pregunta, o trabaja por bloques de columnas que
compartan un sentido.
Plotly o Altair sirven cuando necesitas inspeccionar un punto concreto, o
filtrar un subconjunto, sin rehacer la figura. Para publicar, exporta una
imagen que se entienda sin pasar el cursor: unidades, denominadores y una
frase que diga qué debe verse. Una nube muy densa, dibujada con puntos
opacos, esconde la frecuencia justo donde más puntos hay. Sustitúyela por
hexbin, por una densidad o por un muestreo cuya fracción dejes escrita.
Las guías oficiales de Polars y DuckDB para Python son el punto de partida cuando la tabla ya no cabe cómodamente en memoria, o cuando las agregaciones se vuelven lentas. La velocidad no corrige una muestra mal tomada. Una muestra conveniente puede excluir un periodo, una región o los casos raros que justificaban el análisis. Mide la cobertura: compara conteos, rangos de fechas y prevalencia entre la muestra y el total. Consulta también la documentación de YData Profiling si necesitas automatizar el inventario inicial. Un informe que marca cien columnas como muy correlacionadas te debe devolver al diccionario de datos, no a una lista de variables eliminadas.
Cómo redactar conclusiones útiles
Una conclusión de EDA separa cuatro cosas que el lenguaje cotidiano mezcla. La observación es lo que mediste: cuántos, en qué grupo, con qué denominador. La posible explicación es una historia compatible con esa observación; suele haber más de una, y el texto debe decirlo. La decisión es lo que vas a hacer en el pipeline a partir de lo anterior. La comprobación pendiente es lo que todavía podría tumbar esa decisión. «Hay muchos outliers» no es una conclusión: no dice cuántos, respecto de qué regla, ni qué harás con ellos.
| Observación en este ejemplo | Decisión inicial | Qué falta comprobar |
|---|---|---|
| Faltan gastos de forma desigual entre planes | Imputación dentro del pipeline e indicador de ausencia | Estabilidad de la captura y efecto en validación por grupo |
| La cola de gasto eleva la media sobre la mediana | Conservar extremos válidos; comparar una transformación | Si cambia el rendimiento y el error en clientes de gasto alto |
| Gasto anual y mensual son casi equivalentes | Excluir gasto anual estimado | Que no contenga otra información en la fuente real |
| El reembolso ocurre después del objetivo | Excluirlo | Disponibilidad temporal de todas las demás columnas |
| Hay alrededor de un 21 % de positivos | Evaluar precisión, exhaustividad y AP además de exactitud | Coste de intervención, capacidad y calibración |
| Los dos componentes PCA conservan solo la mitad de la varianza | Usarlos como vista parcial | Patrones en las dimensiones omitidas |
Fíjate en que ninguna fila salta de la observación a «el modelo funcionará». La primera, por ejemplo, observa un hecho de captura, decide un tratamiento provisional y deja escrita la condición que lo invalidaría: que el mecanismo de ausencia cambie en producción, o que el indicador perjudique a un grupo. Ese tercer hueco es el que suele faltar en un informe, y es el que evita convertir una exploración en una promesa.
Registra también los hallazgos negativos. Una hipótesis razonable que no se sostuvo —por ejemplo, que el gasto separaba el abandono con la misma claridad que las incidencias— evita que alguien, tú dentro de tres meses, repita el mismo callejón. Guarda la versión de los datos, la semilla, las reglas de exclusión, el código, los tamaños muestrales y las decisiones. Un gráfico sin ese rastro no se puede defender ni corregir. Y no publiques identificadores personales ni ejemplos sensibles en un informe de diagnóstico: el EDA maneja filas reales con la misma obligación de reserva que el modelo.
# La prueba queda reservada: no se utiliza para gráficos ni selección.(SALIDA / "resultados.json").write_text( json.dumps(resultados, ensure_ascii=False, indent=2), encoding="utf-8")assert len(list(SALIDA.glob("[0-9][0-9]-*.webp"))) == 11print("Resultados y gráficos guardados en:", SALIDA)Antes de pasar a modelos más complejos deberías poder contestar, por escrito, cuatro preguntas. Qué fila predices. Con qué información, disponible en el momento de la predicción. Para qué población vale el resultado. Y cómo sabrás si funciona, con qué métrica y contra qué referencia. Si alguna respuesta depende de una suposición no verificada, no la disimules en el código. Déjala escrita al lado de la decisión que sostiene.
Ejercicios para practicar la interpretación
Los ejercicios no piden que reproduzcas las figuras. Piden que cambies una pieza del mecanismo y mires qué se rompe en la interpretación. Esa es la habilidad que el código, por sí solo, no entrena.
- Cambia la semilla y repite el programa. Identifica qué cifras fluctúan y qué patrones se mantienen. Explica por qué una tasa de un grupo pequeño varía más que la de un grupo grande. Relaciona la respuesta con el ancho de los intervalos de Wilson, no solo con la impresión visual.
- Haz que la ausencia de gasto dependa de su importe, no solo del plan. Compara la distribución de los valores observados con la distribución completa que conoces en la simulación. Describe el sesgo que introduce eliminar filas incompletas, y di si el gráfico de ausencias por plan bastaría para descubrir el nuevo mecanismo.
- Compara la curva precisión–recall con y sin
reembolso_posterior, solo como demostración de fuga y manteniendo intacta la prueba. Explica por qué una mejora espectacular puede invalidar el experimento, aunque la validación cruzada esté bien programada. - En la relación en U, compara una recta con una representación que incluya
x**2, usando validación separada. Relaciona el resultado con el fracaso de usar la correlación marginal como único filtro de variables. - Repite el análisis temporal con huecos en el calendario. Comprueba qué significa ahora una ventana de siete filas y cómo difiere de siete días. Reescribe la media previa para que siga usando días, no posiciones.
- Redacta una ficha con una observación, dos explicaciones alternativas y una comprobación capaz de distinguirlas. Elige un hallazgo del caso de clientes. Así practicas el razonamiento que el código no escribe por ti.
Libros y artículos para seguir estudiando
Selección revisada el 23 de septiembre de 2026. Distingo los recursos para aprender los fundamentos de la investigación reciente sobre automatización. Un artículo sobre agentes no sustituye una introducción a muestreo, distribuciones y validación. Si vas a leer en orden, empieza por Think Stats para el oficio exploratorio, sigue con An Introduction to Statistical Learning para conectar esa exploración con los modelos, y deja los dos artículos de automatización para cuando ya puedas juzgar cómo verifican un hallazgo.
| Recurso | Fecha o edición | Qué aporta |
|---|---|---|
| Allen B. Downey, Think Stats | 3.ª edición, 2025 | Un recorrido con Python por EDA, distribuciones, estimación y relaciones; empieza por los capítulos iniciales y reproduce sus ejercicios |
| James, Witten, Hastie, Tibshirani y Taylor, An Introduction to Statistical Learning with Applications in Python | 2023 | Conecta la exploración con regresión, clasificación, remuestreo y aprendizaje no supervisado; incluye laboratorios y PDF en el sitio de los autores |
| Wes McKinney, Python for Data Analysis | 3.ª edición, 2022; edición web actualizada para pandas 2.0 en 2023 | Profundiza en carga, limpieza, agrupación, uniones y series temporales; útil cuando el obstáculo es preparar correctamente la tabla |
| Manatkar, Akella, Narayanam y Mehta, Question-guided Insights Generation for Automated Exploratory Data Analysis | AAAI 2025, artículo de demostración | Presenta QUIS, un sistema que guía la exploración mediante preguntas y búsqueda de subespacios; permite estudiar cómo priorizar candidatos a hallazgos |
| Liu y colaboradores, DataSTORM: Deep Research on Large-Scale Databases using Exploratory Data Analysis and Data Storytelling | Prepublicación de abril de 2026; revisión de agosto de 2026 | Investiga exploración y construcción de narrativas con agentes sobre bases estructuradas y fuentes web; es investigación avanzada, no una garantía de conclusiones correctas |
La tercera edición de Think Stats fue publicada en abril de 2025, según la ficha de O’Reilly. Los libros anteriores siguen siendo útiles para fundamentos, pero contrasta las llamadas a bibliotecas con su documentación actual.
Al leer trabajos de automatización, examina cómo verifican los hallazgos, qué datos utilizan, qué comparaciones descartan y cuánto depende el resultado de decisiones humanas. Una narración convincente debe poder rastrearse hasta cálculos reproducibles y un diseño de análisis defendible. Si el sistema no puede decir qué pregunta hizo, sobre qué subconjunto, y qué alternativas descartó, no ha hecho un EDA: ha hecho un resumen.
Videos para acompañar la práctica
Estos seis tutoriales ofrecen práctica en español, inglés, francés y alemán. Míralos para observar cómo se formula una pregunta y cómo se revisa una tabla antes de pasar al gráfico siguiente. No los uses como catálogo de llamadas que copiar: algunas APIs han cambiado, y la versión que importa es la que tienes instalada.
En español, el video de Profe Zero combina exploración y visualización con pandas y Seaborn; el de Codificando Bits se concentra en crear gráficos con Seaborn. En francés, OpenAcademyCode presenta cómo explorar e interpretar los datos con Python. En alemán, Dennis Patrick dedica una lección de su curso de pandas a la exploración de datos. Los dos tutoriales en inglés complementan estos recorridos con ejemplos de EDA en pandas. En todos ellos, fíjate menos en el gráfico resultante y más en el momento en que quien presenta decide que ya ha visto bastante y cambia de pregunta.
Si un video no se reproduce, abre el enlace de su autor en YouTube:
- Español: Profe Zero y Codificando Bits.
- Inglés: Rob Mulla y Alex The Analyst.
- Francés: OpenAcademyCode.
- Alemán: Dennis Patrick.
Resolución de problemas
| Problema | Comprobación y solución |
|---|---|
ModuleNotFoundError | Activa el entorno e instala con python -m pip; comprueba que el intérprete del cuaderno sea el mismo |
| El script termina sin abrir gráficos | Utiliza el backend Agg: abre las imágenes guardadas en graficos-eda/ |
Un bloque falla porque falta train o guardar | Ejecuta las celdas en orden o el archivo completo; los fragmentos comparten estado |
| Una columna numérica aparece como texto | Revisa separadores decimales, símbolos, unidades y cadenas usadas como ausencias antes de convertir |
Una correlación aparece como NaN | Comprueba variables constantes, cantidad de pares completos y tipos de datos |
| La distribución cambia mucho al modificar los intervalos | Compara varios anchos de histograma y una ECDF; no concluyas multimodalidad a partir de una sola configuración |
| El modelo parece casi perfecto | Investiga variables posteriores al objetivo, duplicados, entidades compartidas y preprocesamiento ajustado fuera de los pliegues |
| Un informe automático consume demasiada memoria | Reduce columnas, usa un modo mínimo o una muestra documentada; conserva conteos y grupos raros |
| Los resultados cambian entre ejecuciones | Guarda versiones, semillas, reglas y datos de entrada; comprueba también cambios en orden o dependencias numéricas |
| Los grupos parecen muy distintos con pocas filas | Muestra denominadores e incertidumbre y recopila más observaciones antes de generalizar |
Fuentes verificadas
- Allen B. Downey: capítulo de análisis exploratorio de Think Stats, tercera edición.
- O’Reilly: ficha y fecha de publicación de Think Stats, tercera edición.
- An Introduction to Statistical Learning: ediciones, autores y materiales.
- Wes McKinney: Python for Data Analysis, edición abierta.
- pandas: tratamiento de datos ausentes.
- Seaborn: visualización de distribuciones.
- Seaborn: guía de visualización estadística.
- scikit-learn: errores habituales, preprocesamiento y fuga de información.
- scikit-learn: diseños de validación cruzada.
- scikit-learn: PCA y varianza explicada.
- SciPy: correlación de Pearson y ejemplos de sus límites.
- statsmodels: análisis de series temporales.
- Polars: guía de usuario.
- DuckDB: API para Python.
- YData Profiling: documentación de informes exploratorios.
- Manatkar y colaboradores (2025): exploración automática guiada por preguntas, AAAI.
- Liu y colaboradores (2026): DataSTORM, prepublicación.
- Rob Mulla: Exploratory Data Analysis with Pandas Python.
- Alex The Analyst: Exploratory Data Analysis in Pandas.
- Profe Zero: EDA y visualización con Python, pandas y Seaborn (español).
- Codificando Bits: Seaborn desde cero (español).
- OpenAcademyCode: Comment explorer les donnees (francés).
- Dennis Patrick: exploración con Python y pandas (alemán).
- scikit-learn: definición de average precision.
- statsmodels: intervalos para proporciones, incluido Wilson.
- scikit-learn: detección de anomalías y novedades.